Anglais US


7 modèles de CV pour Data Engineer - AWS et Python, avec exemples
Par Ria · Dernière mise à jour le 19 octobre 2026
Exemple de CV — page 1

Ce guide pratique vous aide à construire un CV de Data Engineer spécialisé en AWS et Python, clair et centré sur les résultats. Vous y trouverez des repères pour organiser vos preuves professionnelles et comparer sept mises en page adaptées à ce rôle.

Pour rendre votre expertise lisible, reliez les pipelines ETL/ELT aux données de recharge, de transaction et de facturation qu’ils fiabilisent. Présentez avec précision vos compétences en Python, PySpark, SparkSQL, AWS Glue, AWS Lambda, Athena et PostgreSQL, puis étayez-les par des réalisations en qualité des données, optimisation des requêtes et reporting.

Les exemples montrent comment hiérarchiser les rubriques, intégrer les mots-clés utiles aux ATS et décrire des contributions mesurables. Chaque aperçu en image permet de comparer la présentation avant d’ouvrir un exemple dans l’éditeur.

Qu’est-ce qui fait un bon CV de Data Engineer AWS et Python en 2026 ?

Un CV convaincant relie les compétences techniques aux besoins de la plateforme : modèles pour les transactions et la facturation, pipelines fiables et données exploitables pour la BI. Des rubriques nettes et des expériences faciles à parcourir rendent cette contribution visible.

Décrivez les méthodes de contrôle qualité, l’optimisation SQL et la documentation de la provenance, puis indiquez les résultats vérifiables. Reprenez naturellement les mots-clés pertinents, comme Python, PySpark, AWS Glue, Athena, PostgreSQL et ETL/ELT.

Note : Les exemples de CV sont fournis à titre pédagogique uniquement. Utilisez uniquement des informations qui reflètent fidèlement votre expérience et vos qualifications. Les références à des organisations réelles n’impliquent aucune affiliation ni approbation de leur part.

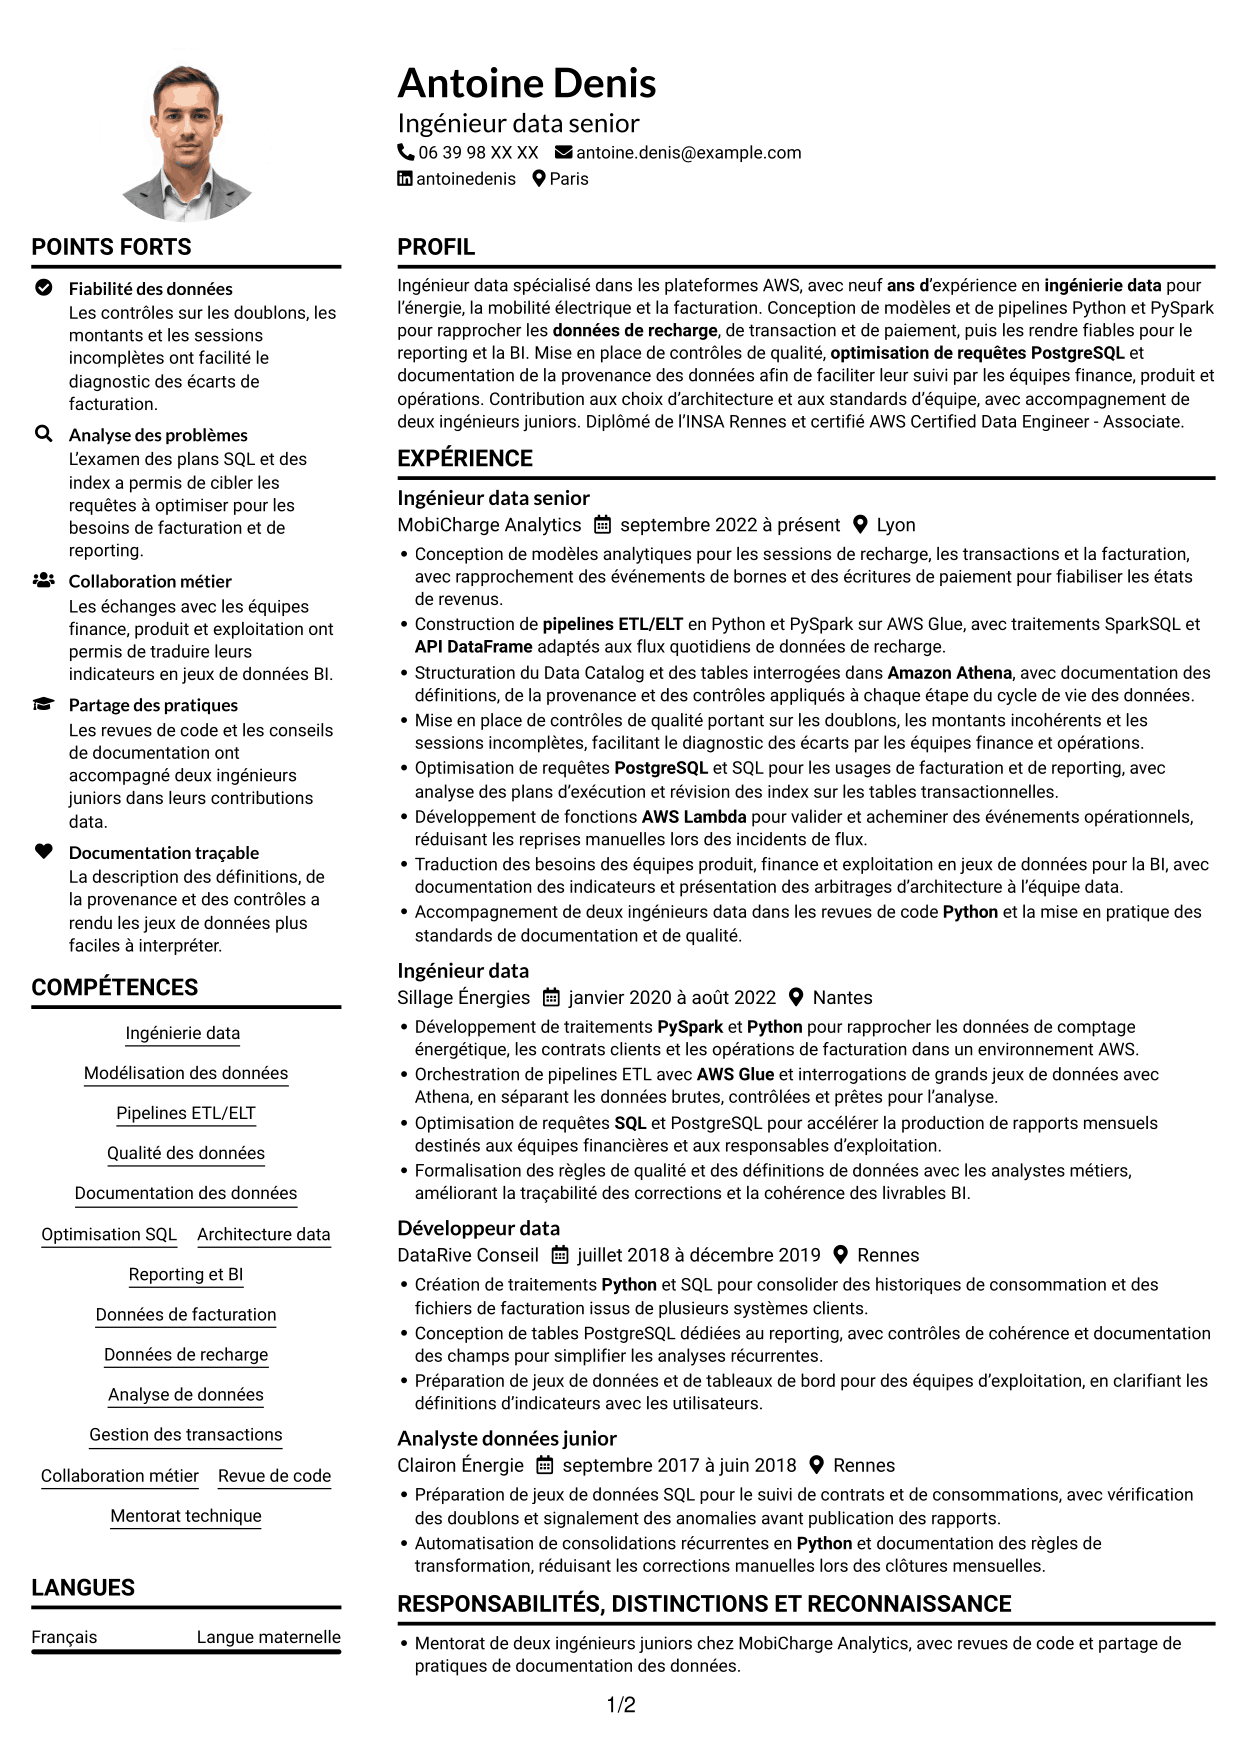
#1 Compact (format sobre à deux colonnes avec photo)

Compact associe une photo en haut à gauche à des séparateurs fins et à une mise en page sobre, un choix adapté pour faire une large place au contenu écrit.
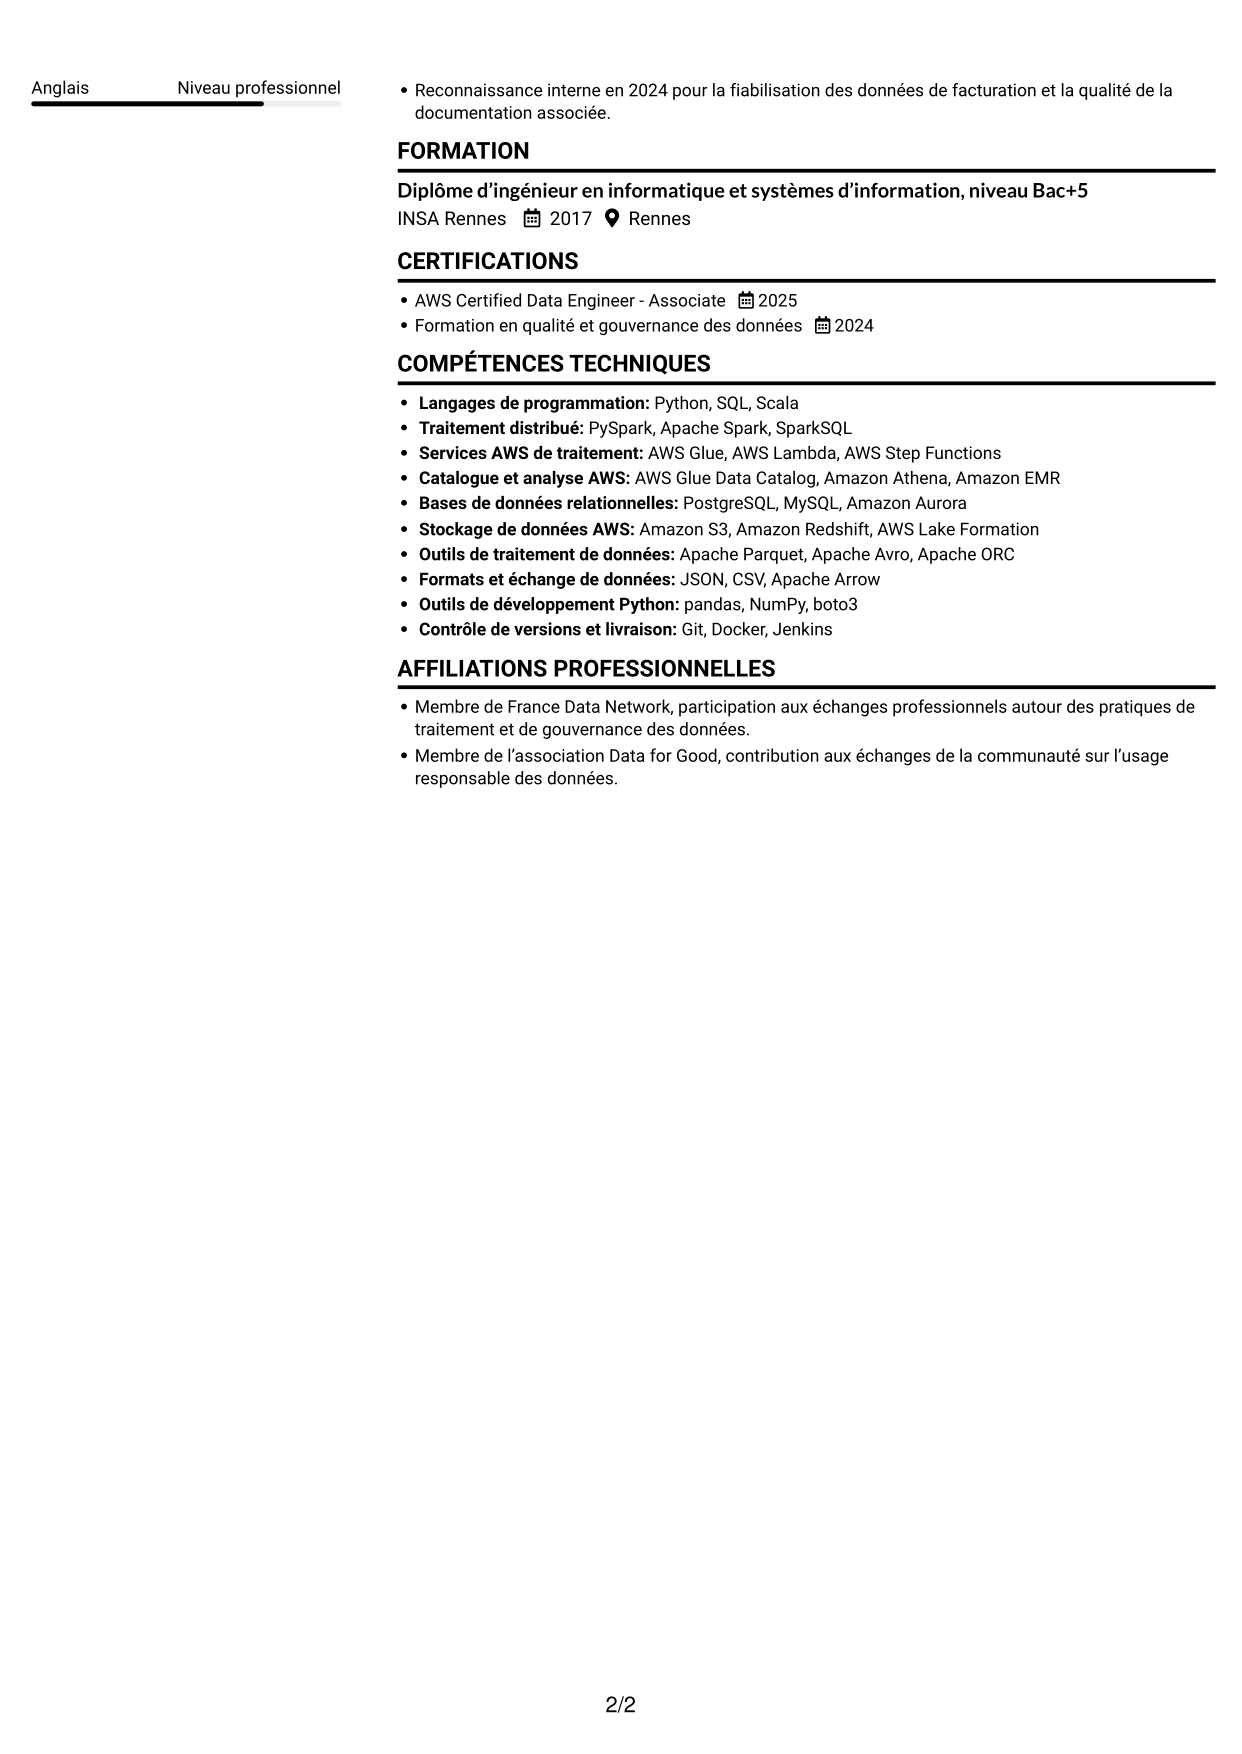
 
CV Compact (format sobre à deux colonnes avec photo) : Data Engineer - AWS et Python, page 1   CV Compact (format sobre à deux colonnes avec photo) : Data Engineer - AWS et Python, page 2

Pourquoi choisir ce modèle ?

  • Les séparateurs fins distinguent les rubriques sans morceler le parcours professionnel.
  • Les deux colonnes maintiennent les compétences et l’expérience dans un ordre de lecture net.
  • Le fond blanc laisse une place généreuse aux réalisations et à la formation.

À privilégier pour

  • CV privilégiant le contenu écrit
  • Lecture en deux colonnes
  • Rubriques nettement délimitées
  • Photo discrètement intégrée
  • Parcours professionnel détaillé

Mots-clés du CV

  • Diplôme d’ingénieur en informatique et systèmes d’information, niveau Bac+5
  • neuf ans d’expérience en ingénierie data
  • Python
  • PySpark
  • SparkSQL
  • API DataFrame
  • AWS Glue
  • AWS Glue Data Catalog
  • AWS Lambda
  • Amazon Athena
  • Pipelines ETL/ELT
  • SQL
  • PostgreSQL
  • optimisation de requêtes PostgreSQL
  • Modélisation des données
Voir tous les mots-clés
 

#2 Élégant (format à colonne latérale colorée avec photo)

Élégant contraste une colonne latérale bleue, réservée à la photo et aux informations complémentaires, avec un contenu principal sur fond blanc pour distinguer visuellement les deux zones.
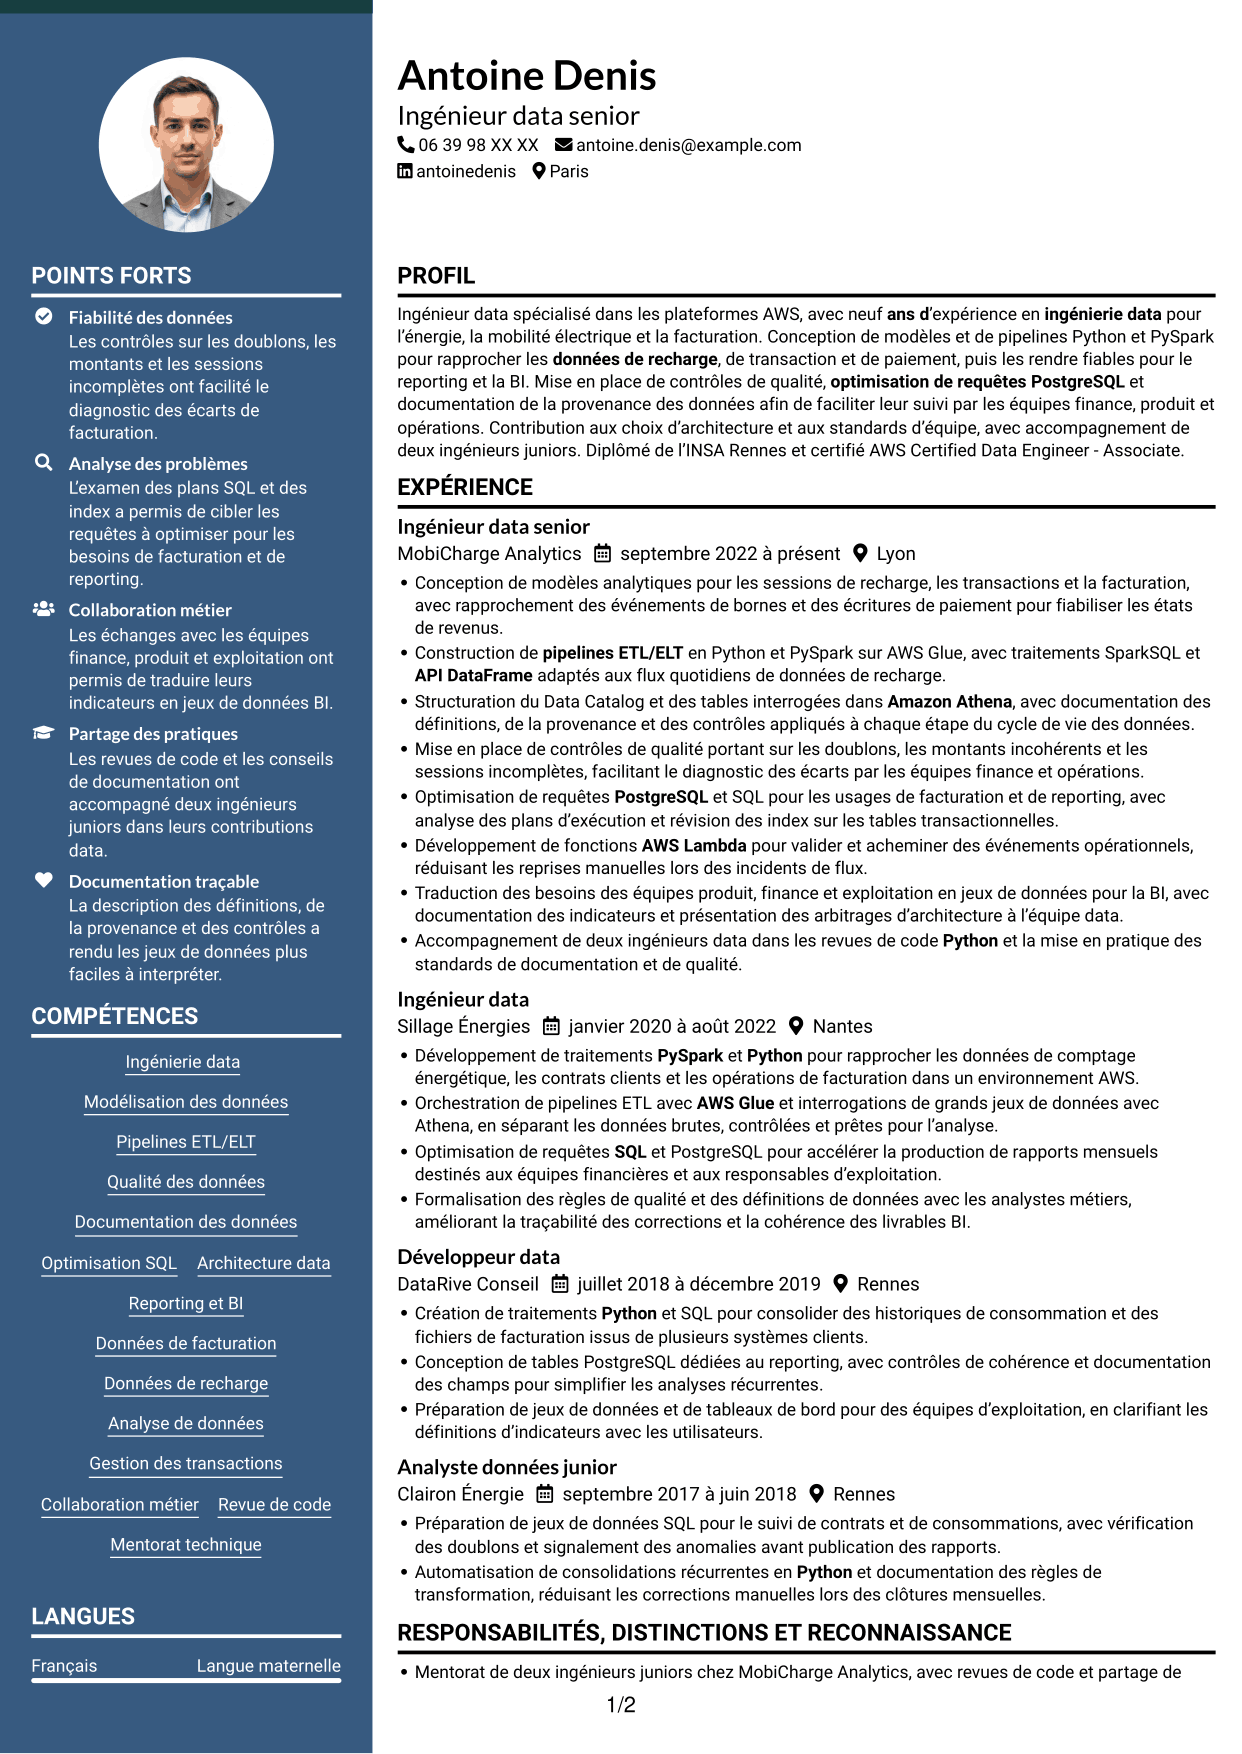
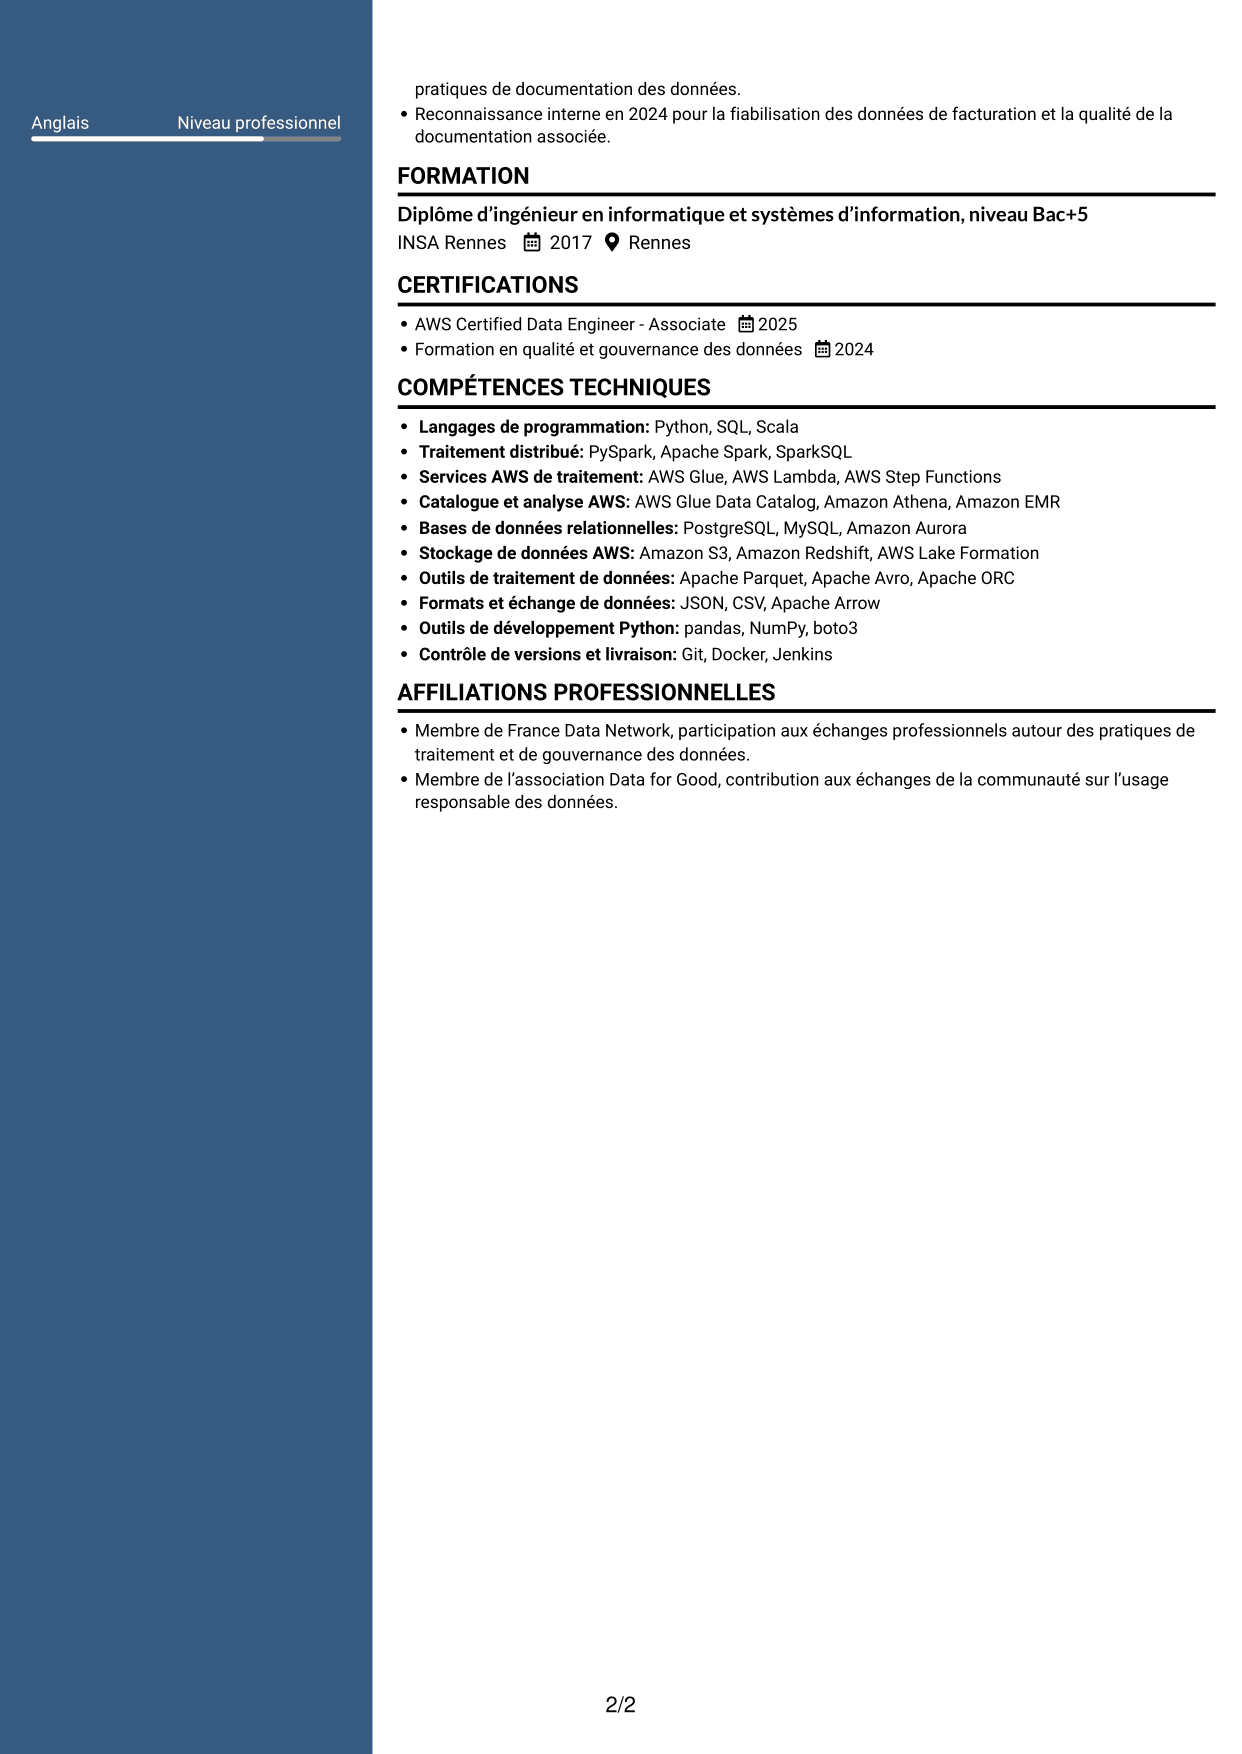
 
CV Élégant (format à colonne latérale colorée avec photo) : Data Engineer - AWS et Python, page 1   CV Élégant (format à colonne latérale colorée avec photo) : Data Engineer - AWS et Python, page 2

Pourquoi choisir ce modèle ?

  • Le contraste entre les deux zones aide à distinguer l’expérience des informations complémentaires.
  • La colonne latérale offre un repère visuel stable au fil des rubriques.
  • Le fond blanc du contenu principal favorise une lecture suivie des réalisations.

À privilégier pour

  • Informations complémentaires en colonne latérale
  • Contraste marqué entre les zones
  • Repères visuels faciles à retrouver
  • Photo associée aux détails complémentaires
  • CV au contenu principal bien dégagé
 

#3 Moderne (format à deux colonnes avec photo à gauche et séparateur)

Moderne place une photo arrondie à gauche et un séparateur entre les deux colonnes ; les titres soulignés apportent des repères sobres pour parcourir les rubriques.
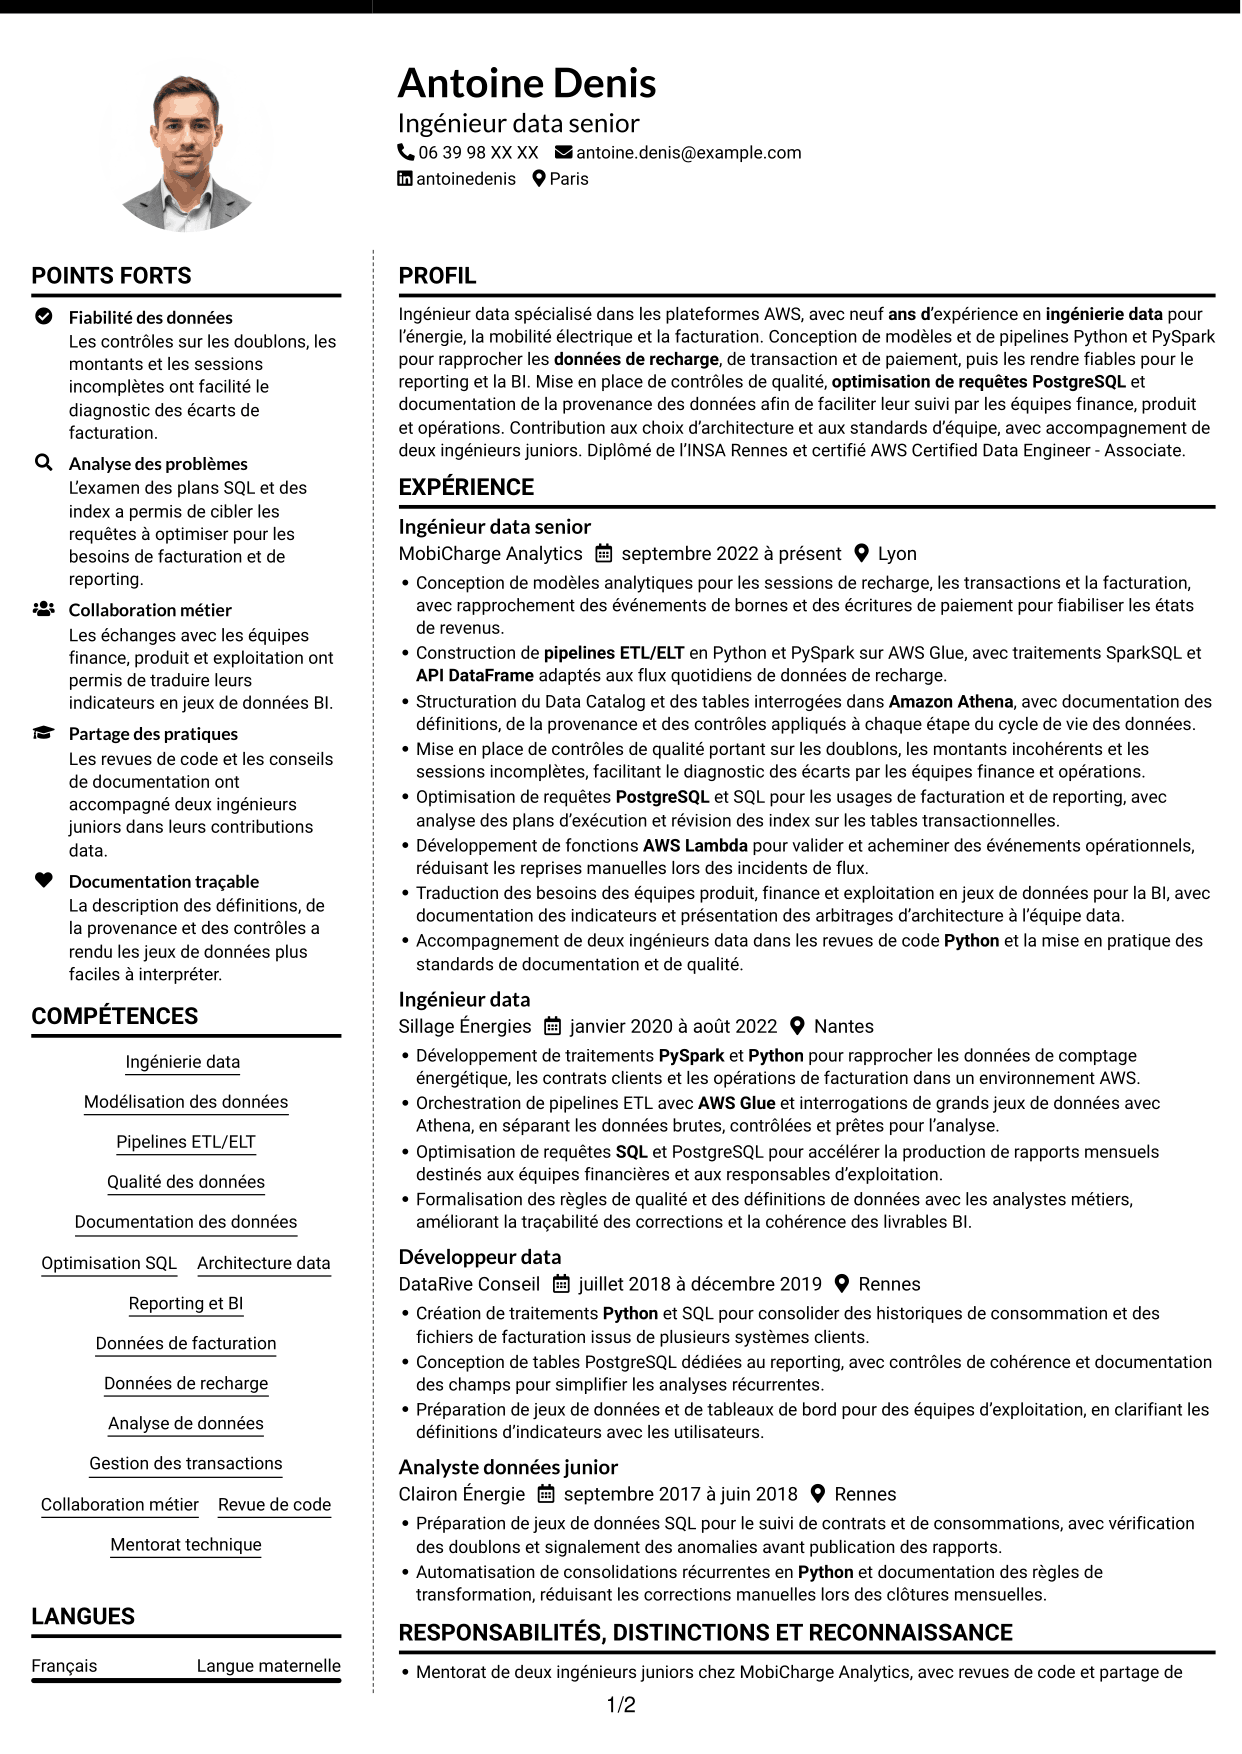
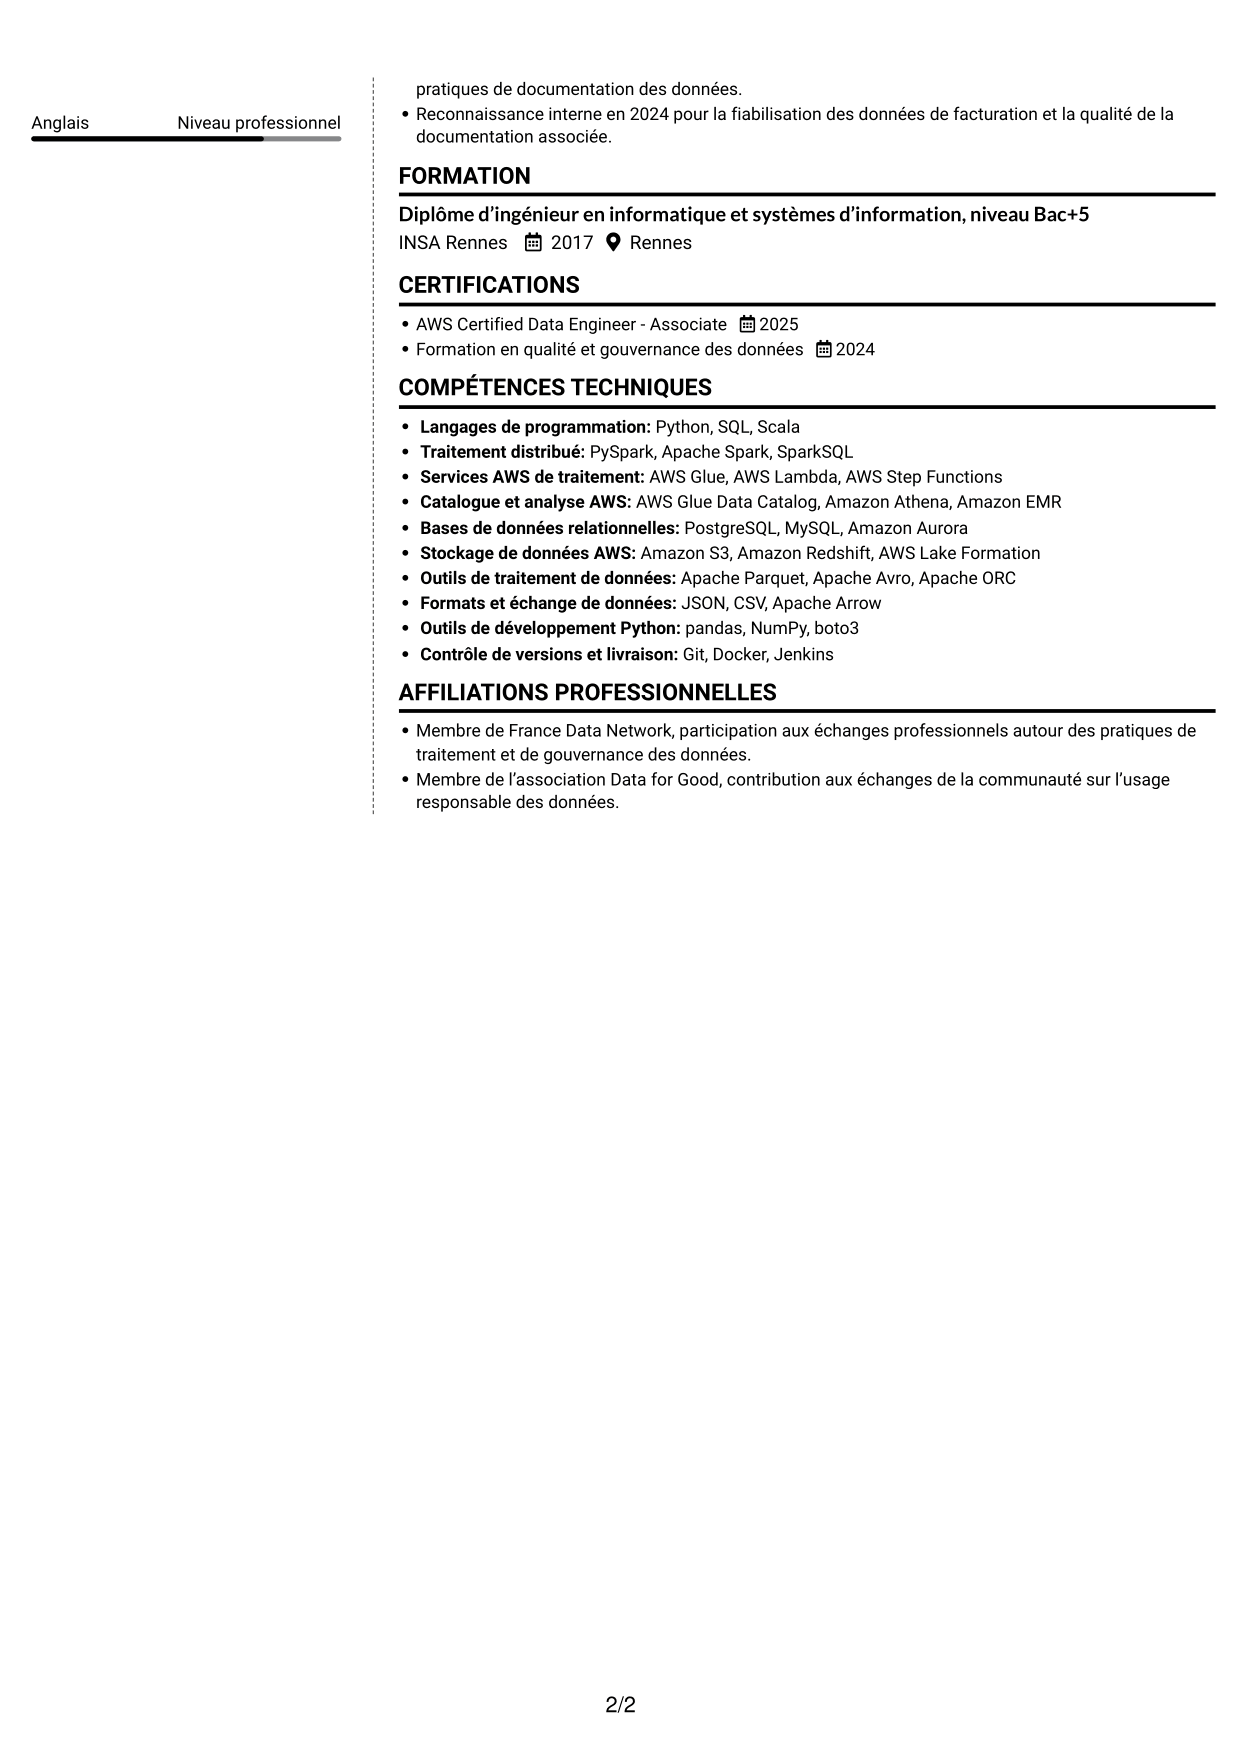
 
CV Moderne (format à deux colonnes avec photo à gauche et séparateur) : Data Engineer - AWS et Python, page 1   CV Moderne (format à deux colonnes avec photo à gauche et séparateur) : Data Engineer - AWS et Python, page 2

Pourquoi choisir ce modèle ?

  • Le séparateur rend la limite entre les colonnes immédiatement visible au lecteur.
  • Les titres soulignés facilitent le repérage des rubriques d’expérience et de formation.
  • La structure en deux colonnes distingue le parcours des informations complémentaires.

À privilégier pour

  • Rubriques faciles à repérer
  • Séparation visible entre les colonnes
  • Titres soulignés et discrets
  • Photo arrondie à gauche
  • CV mêlant parcours et informations complémentaires
 

#4 Audacieux (format à deux colonnes avec accents colorés et photo)

Audacieux reprend une couleur d’accent dans le liseré supérieur, le nom, les icônes et les titres, tout en conservant deux colonnes sur fond blanc pour une présentation structurée.
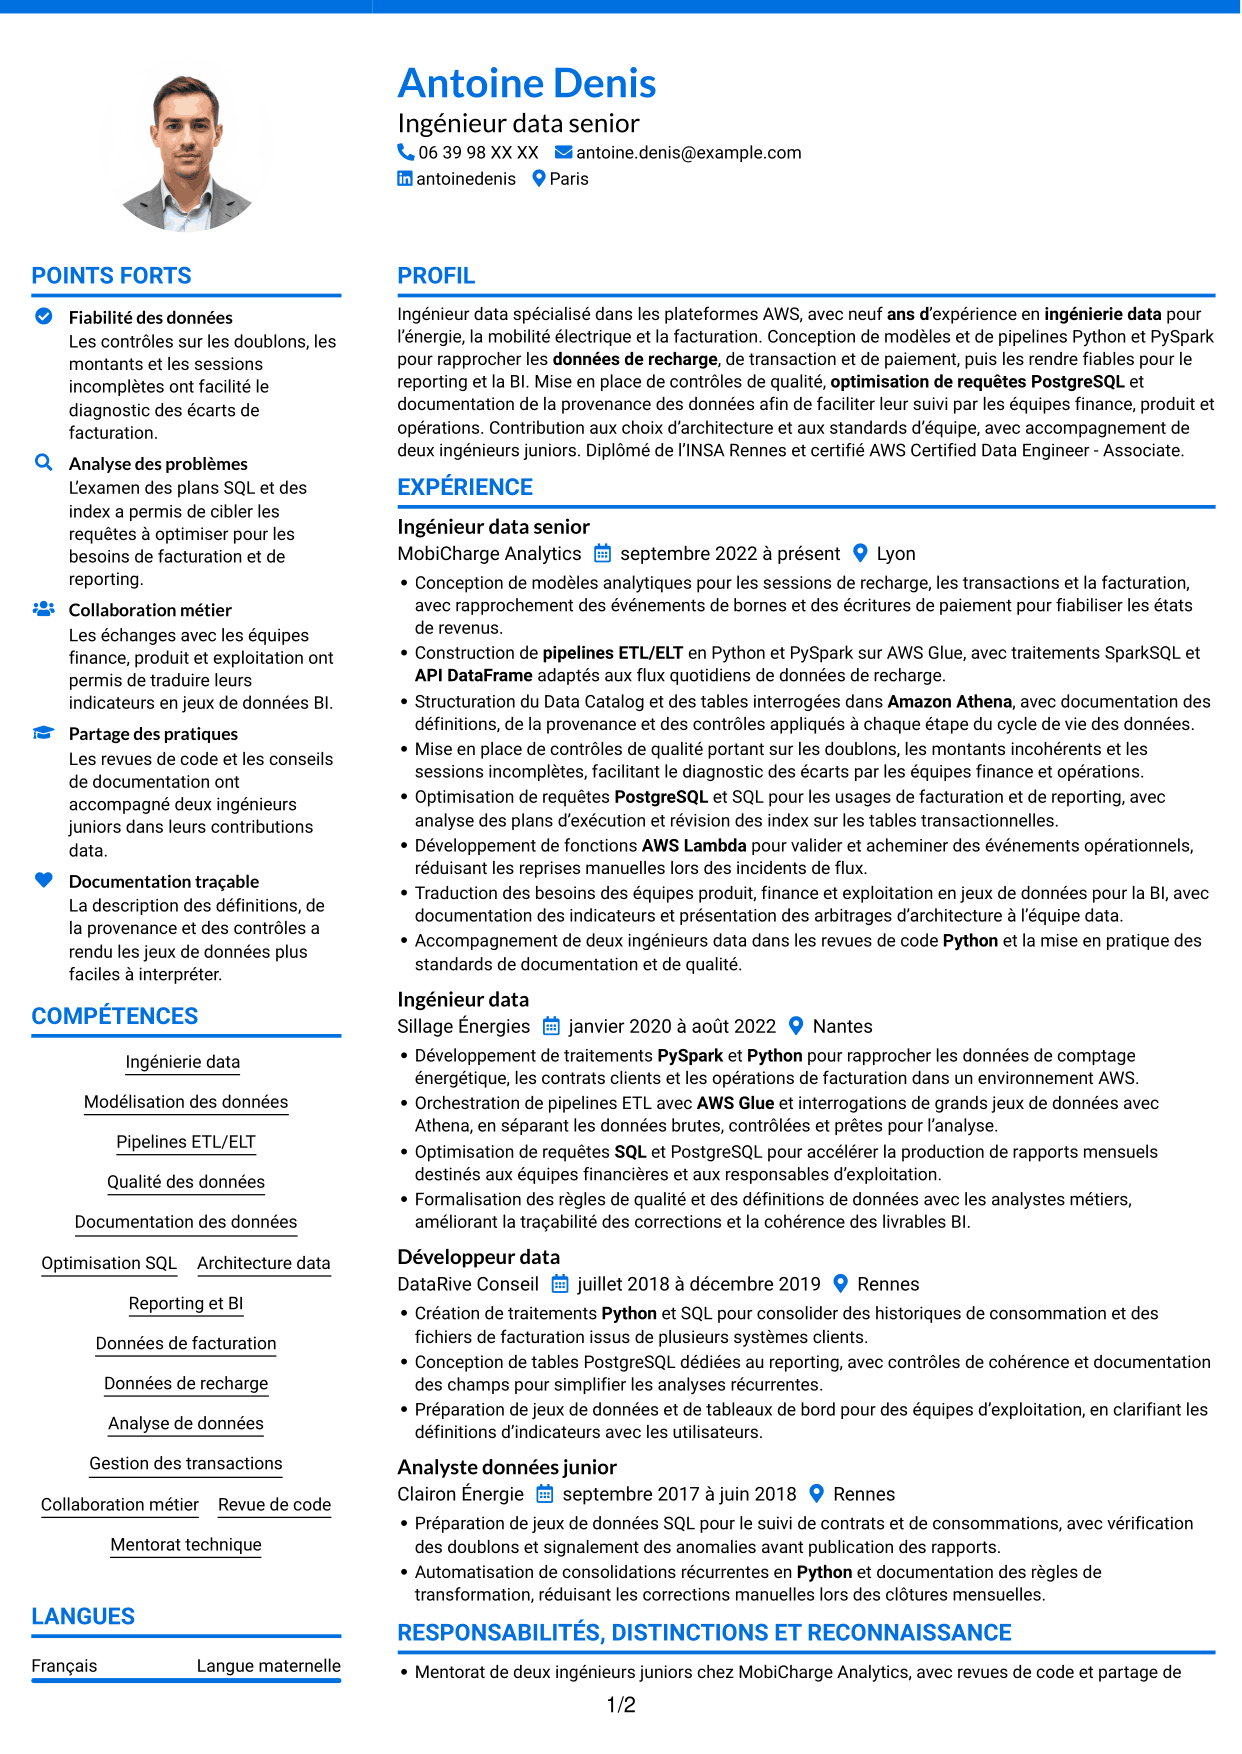
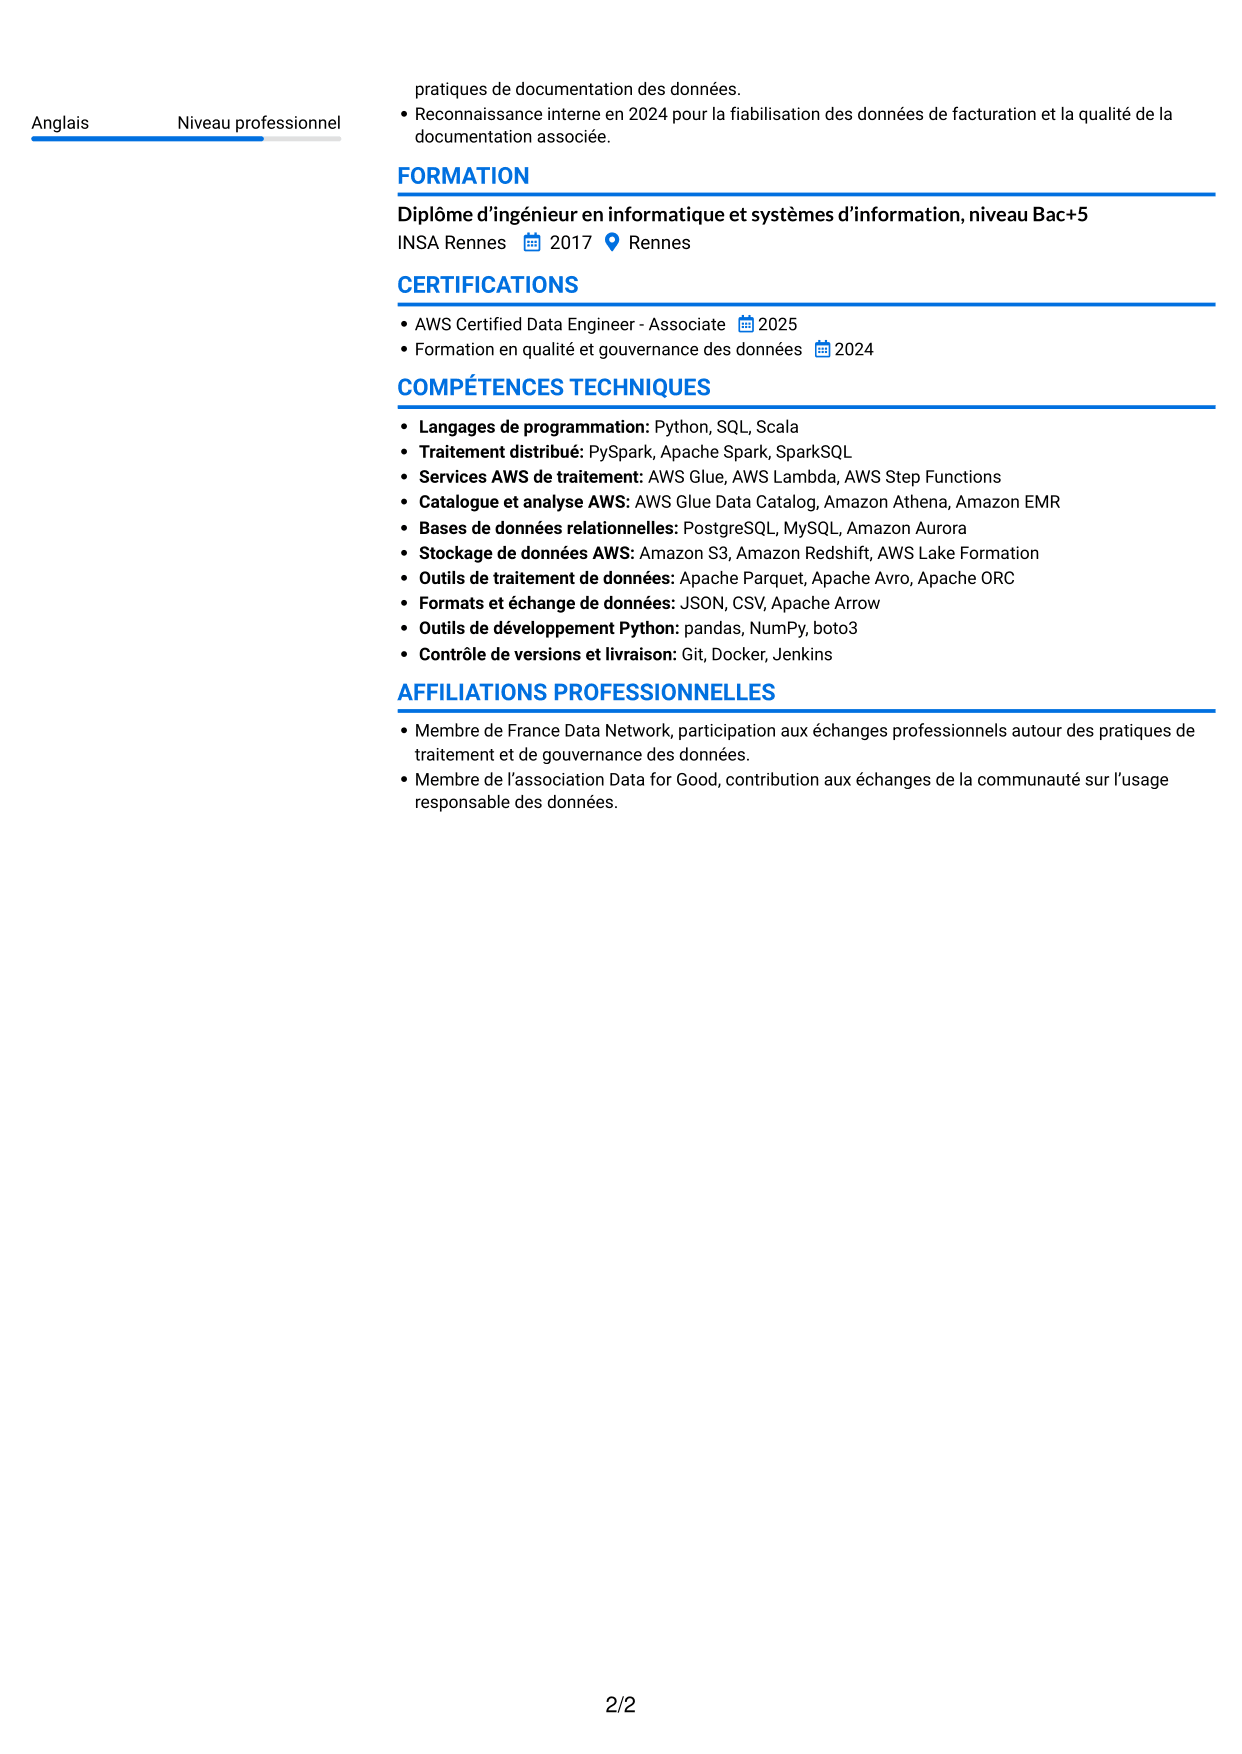
 
CV Audacieux (format à deux colonnes avec accents colorés et photo) : Data Engineer - AWS et Python, page 1   CV Audacieux (format à deux colonnes avec accents colorés et photo) : Data Engineer - AWS et Python, page 2

Pourquoi choisir ce modèle ?

  • Les titres colorés rendent la hiérarchie des rubriques plus visible pendant le balayage du CV.
  • Les deux colonnes séparent visuellement le parcours des informations complémentaires.
  • Le fond blanc préserve une lecture claire malgré les accents graphiques.

À privilégier pour

  • Hiérarchie de rubriques accentuée
  • Lecture structurée en deux colonnes
  • Repères colorés dans les titres
  • Présentation visuellement affirmée
  • Photo intégrée à un fond blanc


#5 Signature (format à colonne latérale colorée avec grande photo)

Signature met en avant une grande photo rectangulaire en haut de la colonne latérale colorée, équilibrée par le contenu principal sur fond blanc pour une présentation avec un portrait bien visible.
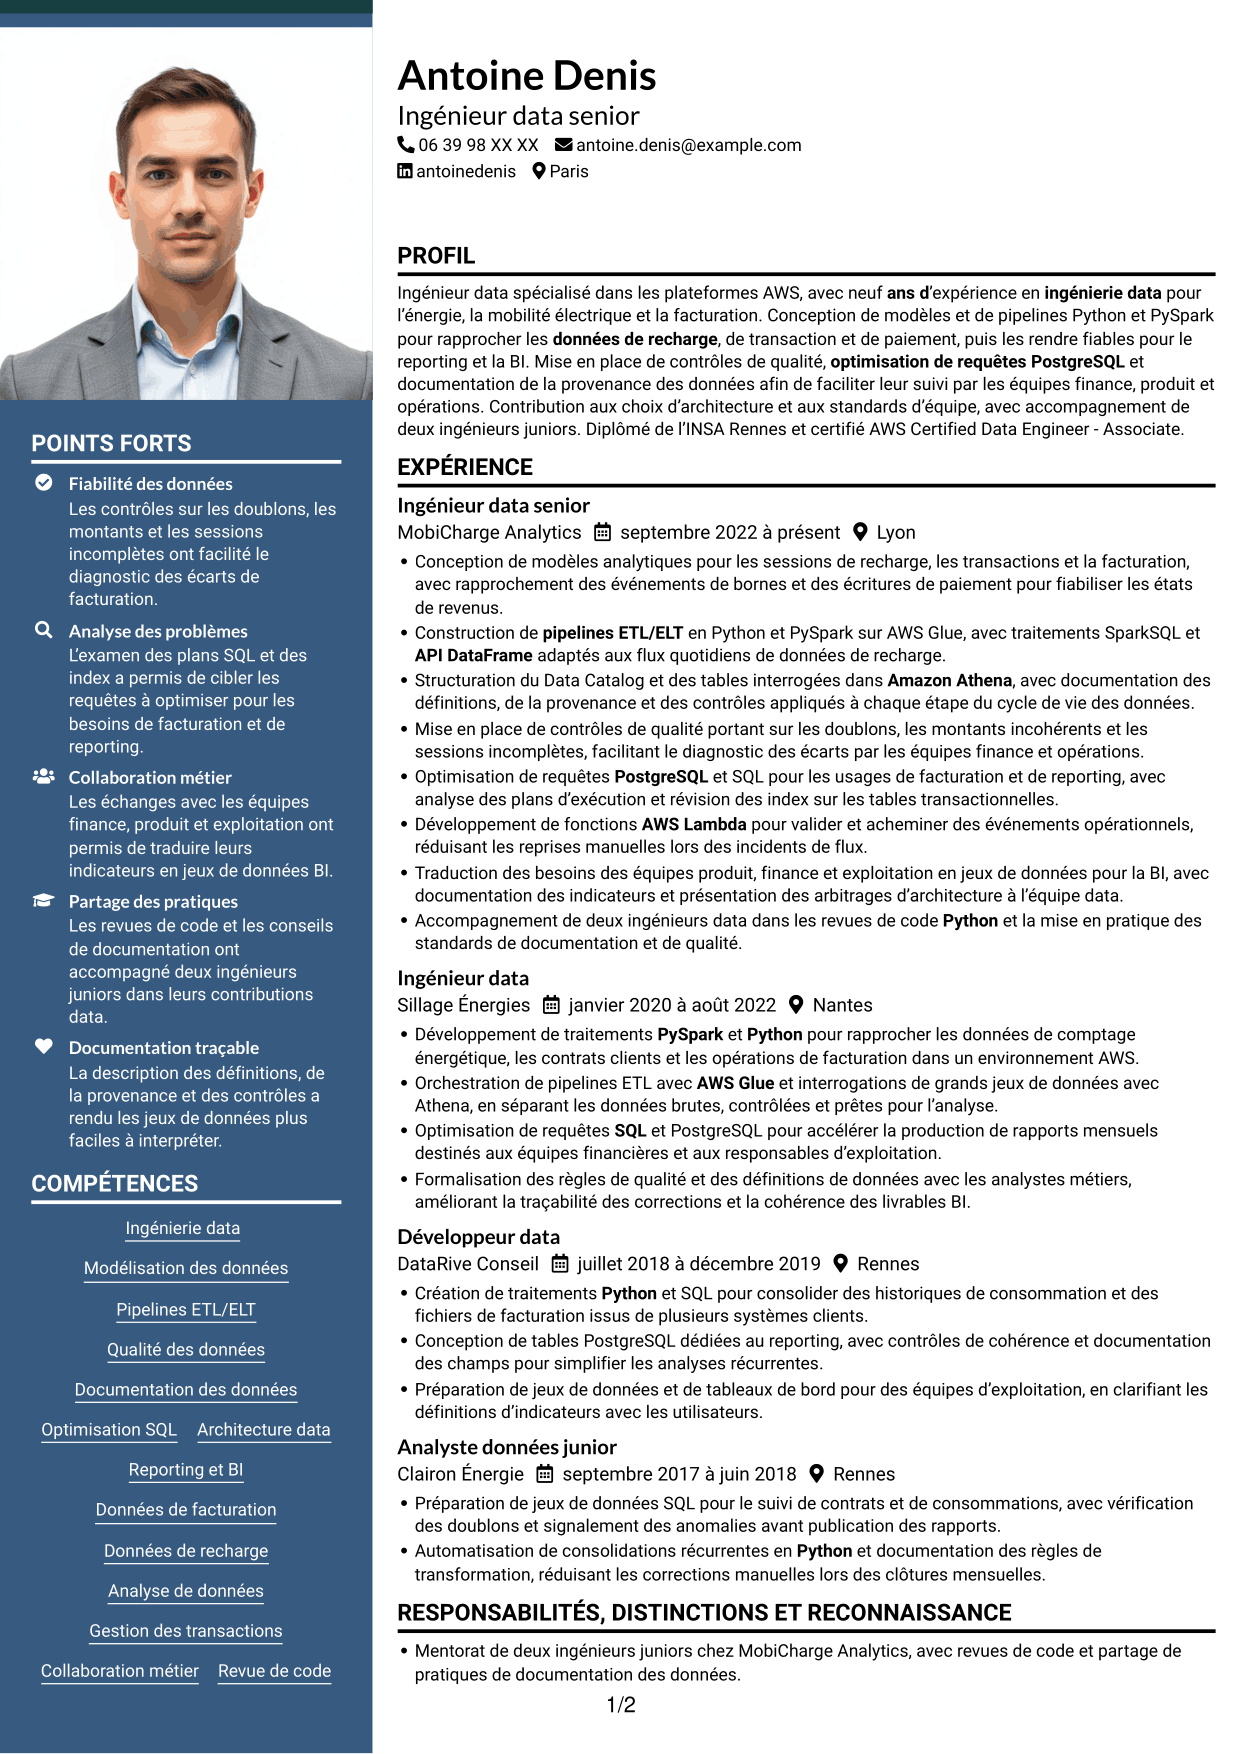
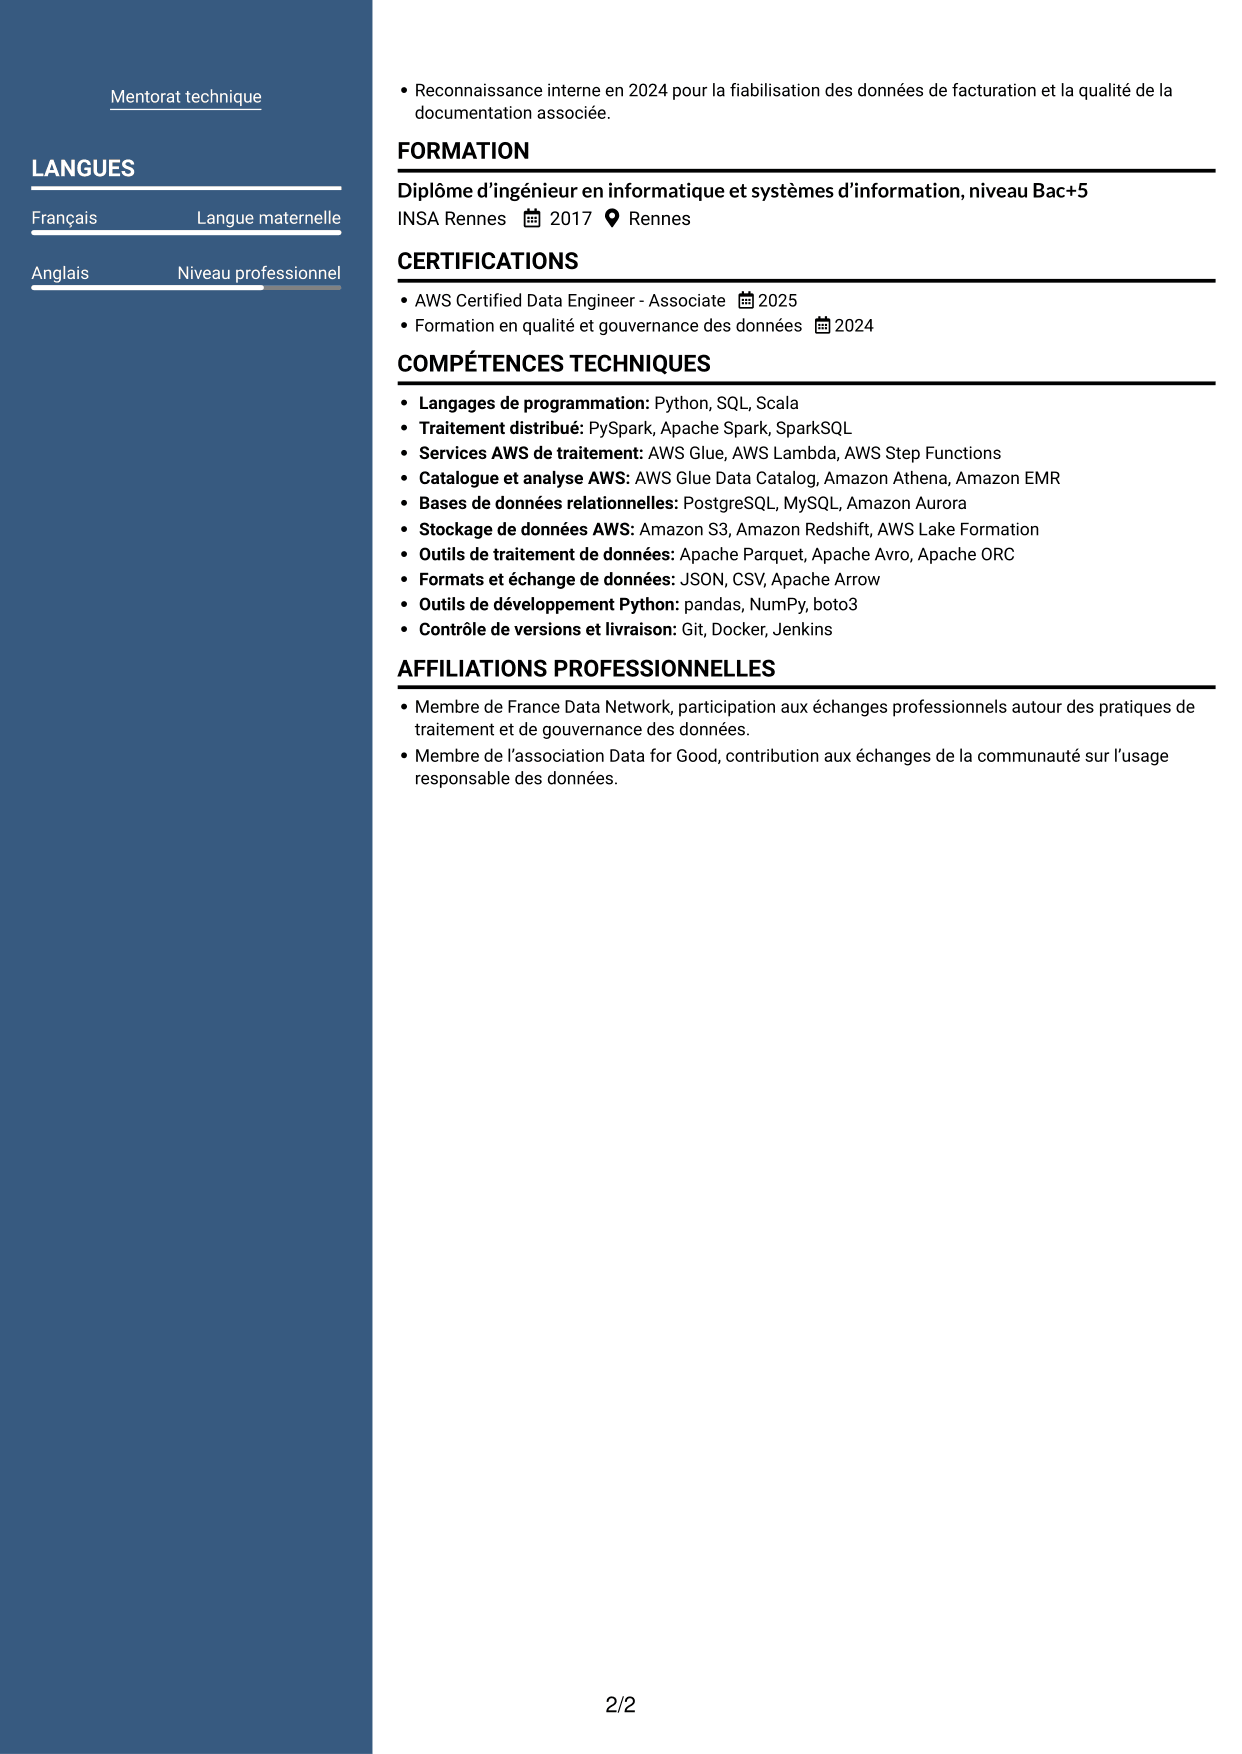
 
CV Signature (format à colonne latérale colorée avec grande photo) : Data Engineer - AWS et Python, page 1   CV Signature (format à colonne latérale colorée avec grande photo) : Data Engineer - AWS et Python, page 2

Pourquoi choisir ce modèle ?

  • La colonne latérale colorée distingue les informations complémentaires du parcours professionnel.
  • La grande photo rectangulaire donne une présence visuelle marquée à l’en-tête.
  • Le contenu principal sur fond blanc conserve une lecture claire des rubriques.

À privilégier pour

  • Photo de grande taille
  • Colonne latérale colorée
  • Parcours présenté sur fond blanc
  • Informations complémentaires dans une zone distincte
  • CV assumant une forte présence visuelle
 

#6 Fonceur (format à deux colonnes avec en-tête centré sans photo)

Fonceur centre le nom et encadre les coordonnées dans l’en-tête, sans photo ; la colonne latérale légèrement teintée distingue les informations complémentaires du contenu principal.
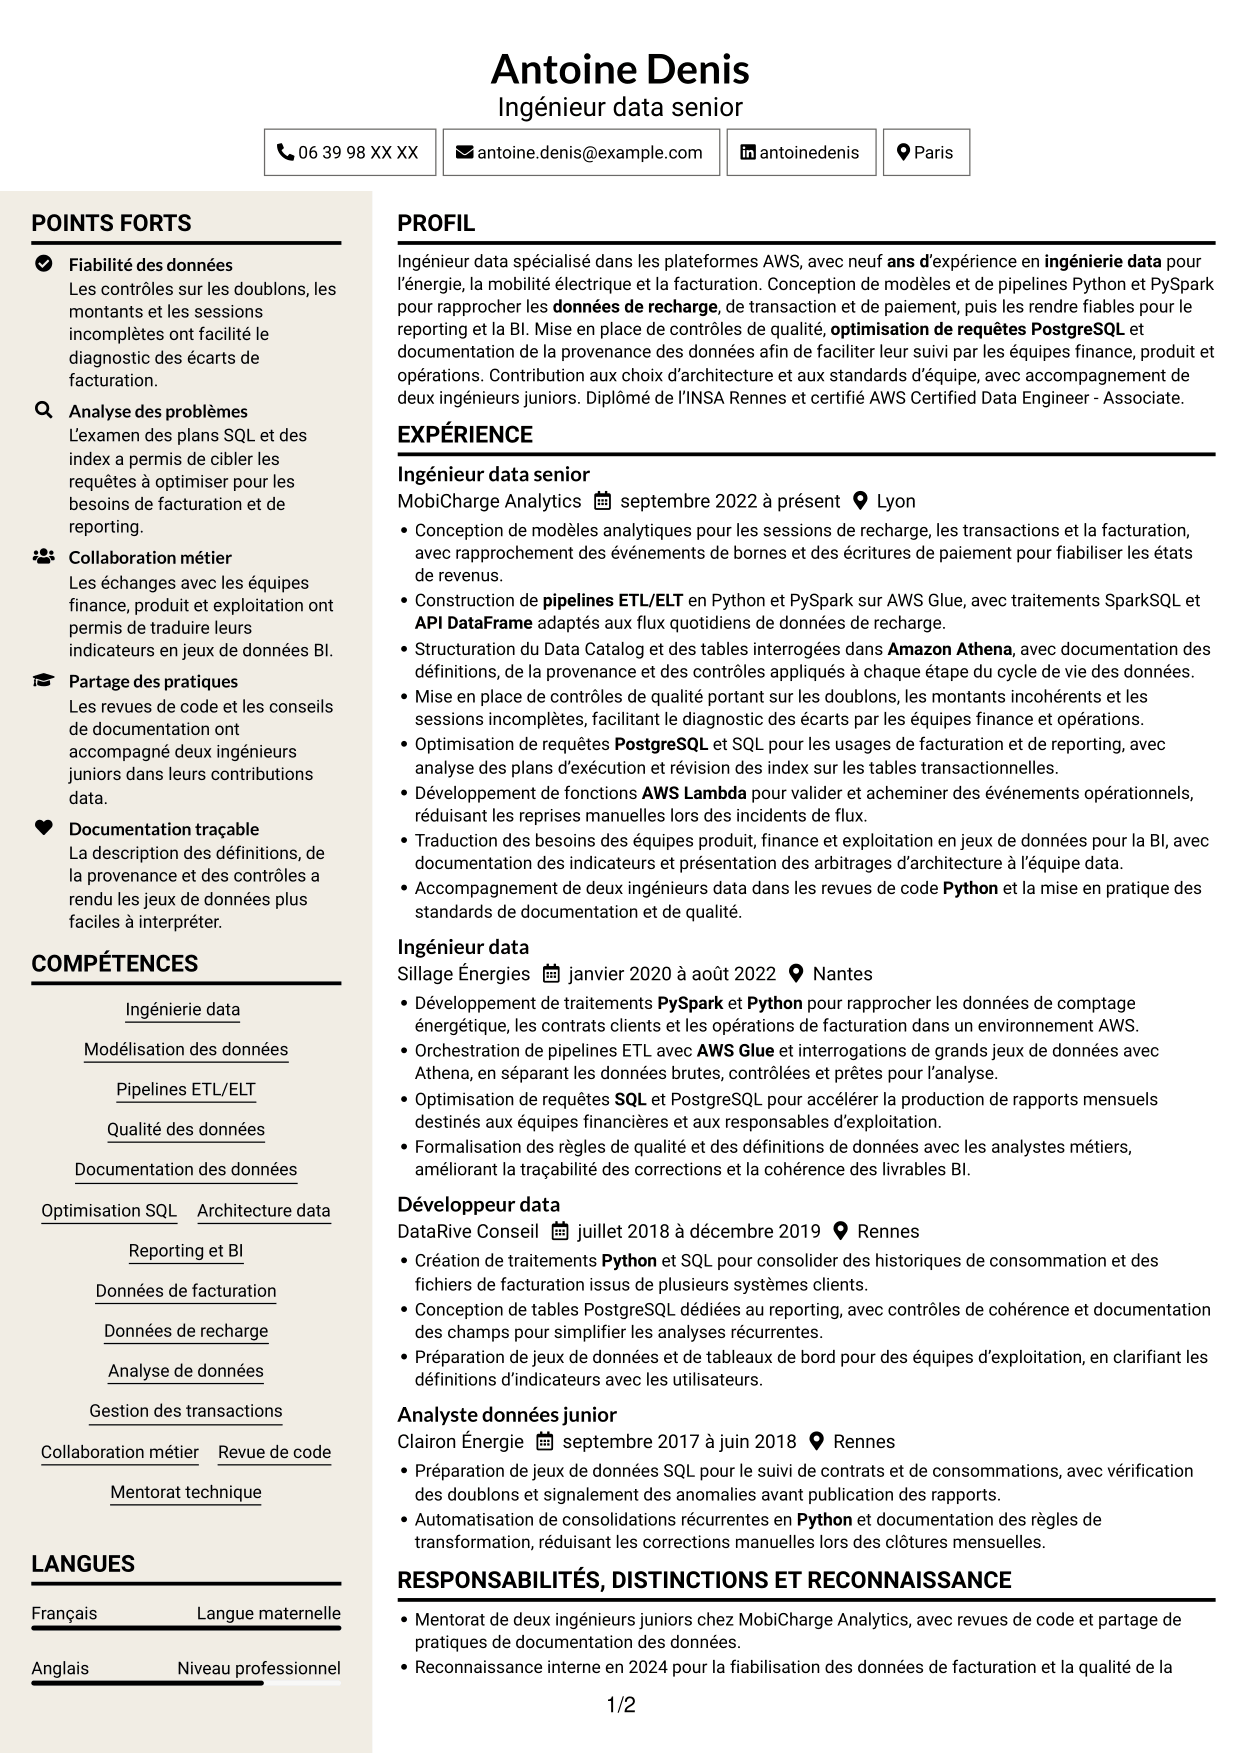
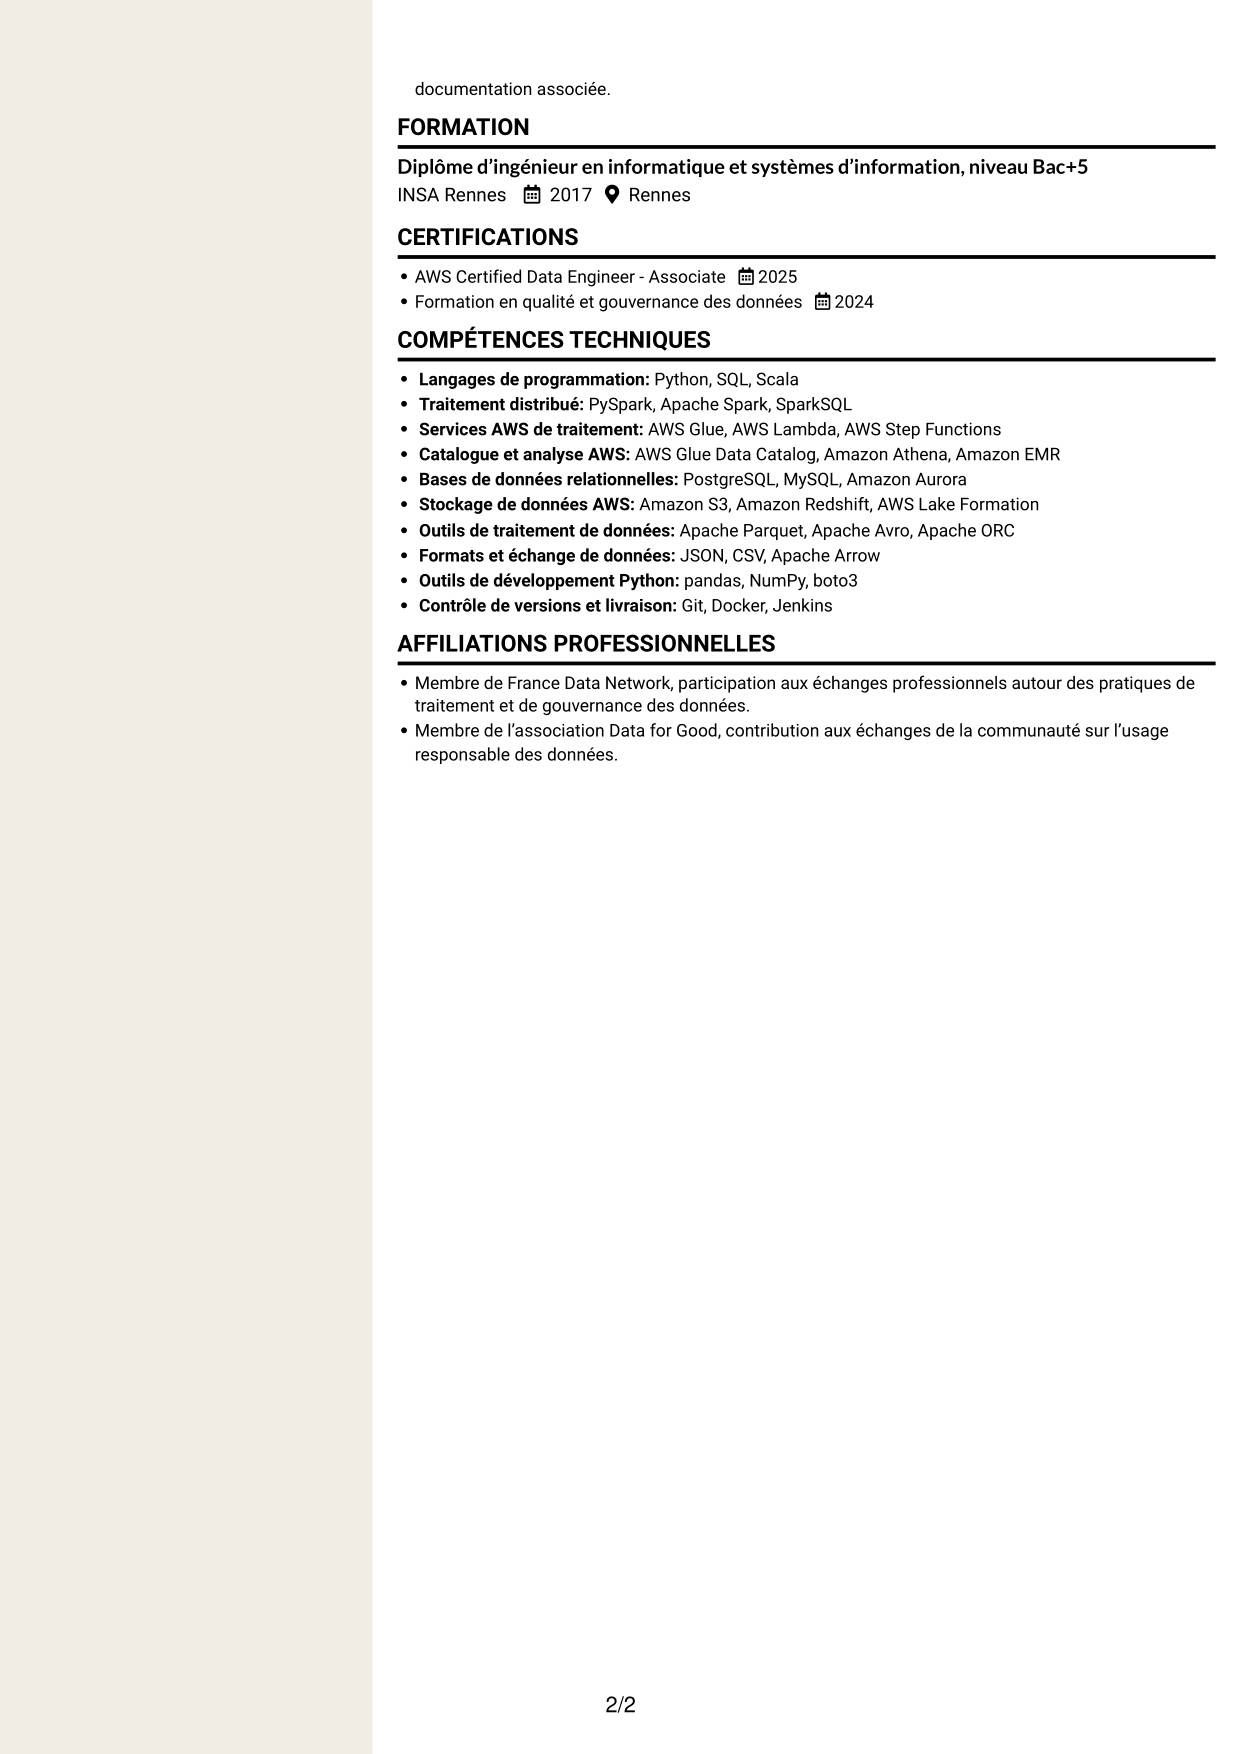
 
CV Fonceur (format à deux colonnes avec en-tête centré sans photo) : Data Engineer - AWS et Python, page 1   CV Fonceur (format à deux colonnes avec en-tête centré sans photo) : Data Engineer - AWS et Python, page 2

Pourquoi choisir ce modèle ?

  • L’en-tête centré et encadré rassemble les coordonnées avant le début du parcours.
  • La teinte de la colonne latérale différencie les informations complémentaires du contenu principal.
  • Les deux colonnes permettent de parcourir distinctement expérience, compétences et formation.

À privilégier pour

  • CV sans photo
  • Coordonnées encadrées dans l’en-tête
  • En-tête centré
  • Informations complémentaires en colonne teintée
  • Lecture distincte du parcours et des compétences
 

#7 Dynamique (format à deux colonnes avec icônes)

Dynamique associe un en-tête centré, un fond clair et des accents dorés aux deux colonnes ; ses trois pictogrammes circulaires sont décoratifs et apportent du rythme visuel.
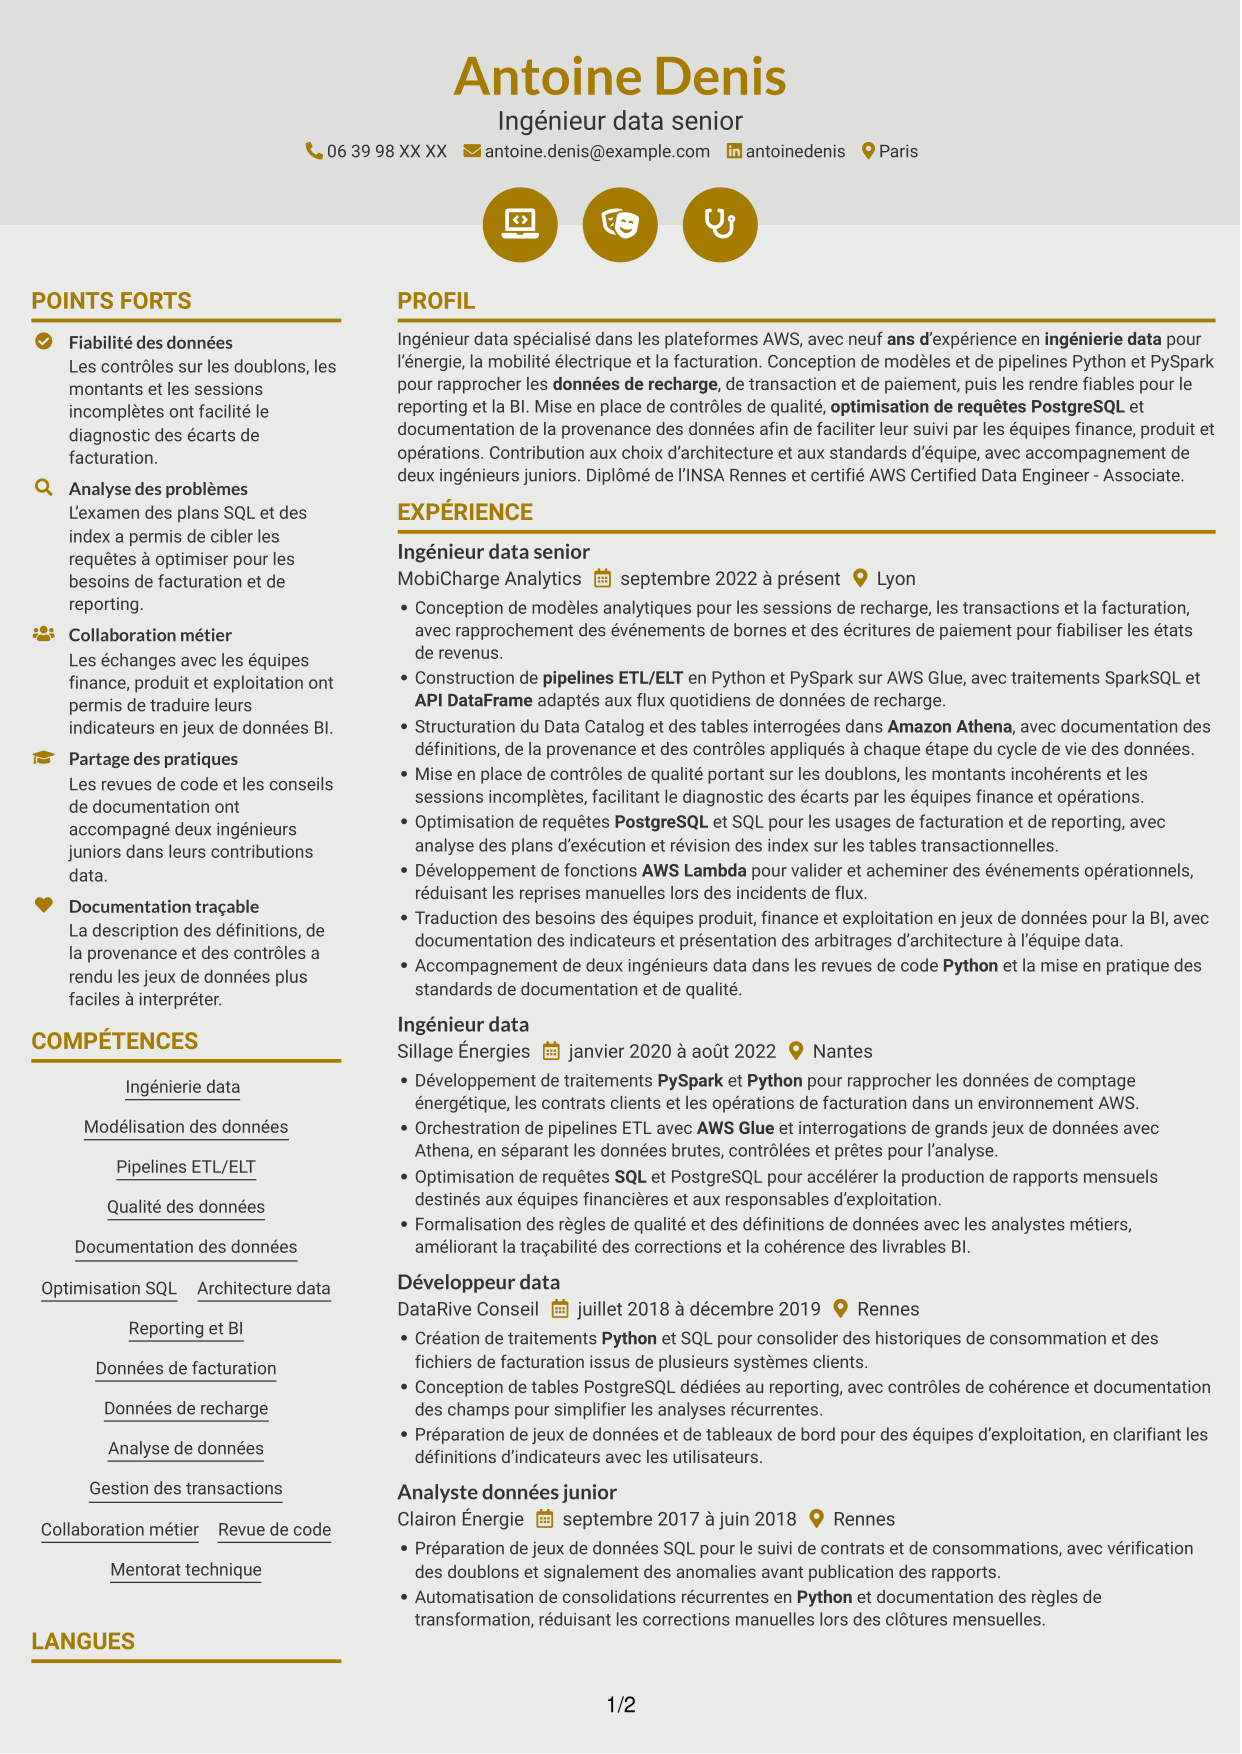
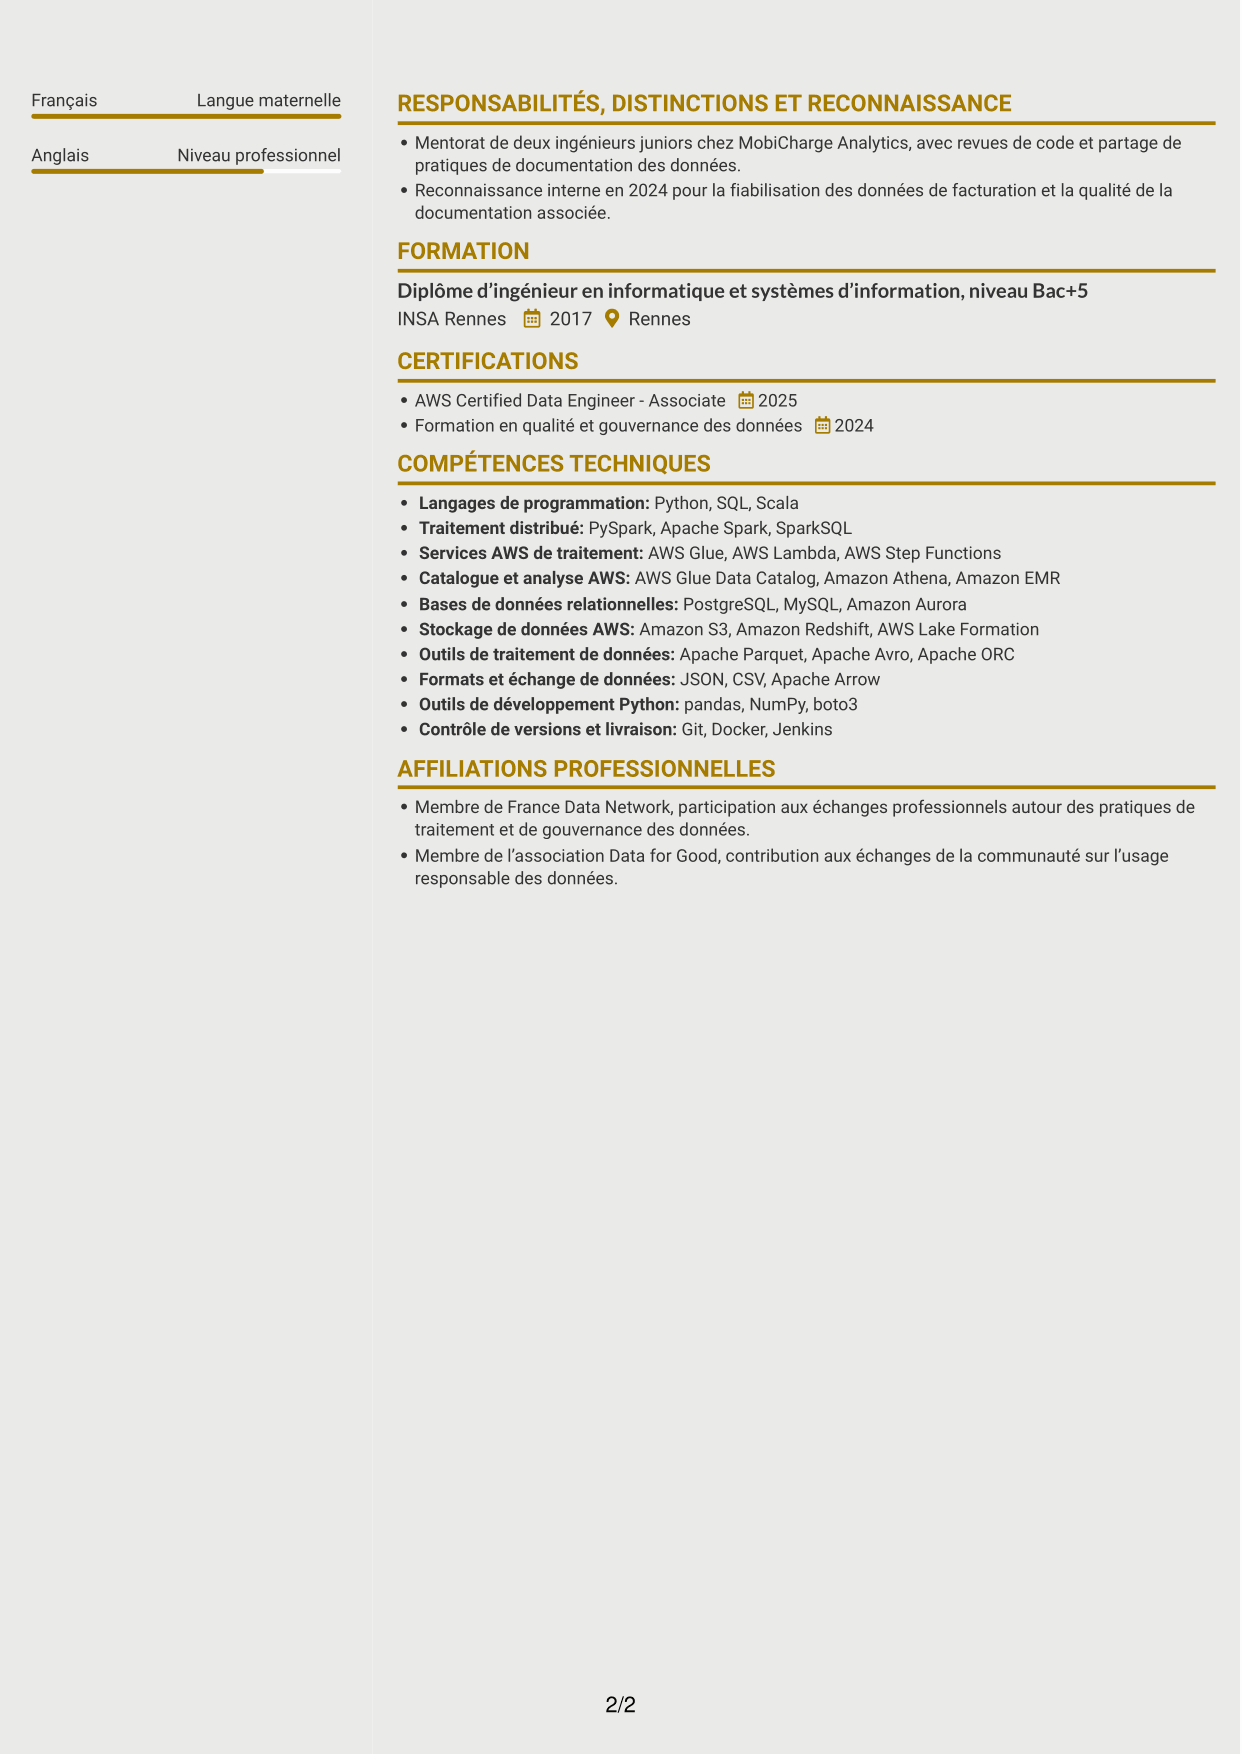
 
CV Dynamique (format à deux colonnes avec icônes) : Data Engineer - AWS et Python, page 1   CV Dynamique (format à deux colonnes avec icônes) : Data Engineer - AWS et Python, page 2

Pourquoi choisir ce modèle ?

  • Les deux colonnes donnent un ordre de lecture distinct au parcours et aux rubriques complémentaires.
  • Le fond clair et les accents dorés font ressortir les limites visuelles des rubriques.
  • L’en-tête centré offre une entrée visuelle nette avant le contenu du CV.

À privilégier pour

  • En-tête centré
  • Lecture en deux colonnes
  • Accents dorés sur fond clair
  • Pictogrammes décoratifs
  • Présentation visuelle rythmée


Pourquoi créer votre CV de Data Engineer AWS et Python avec ResumeInMinutes ?

ResumeInMinutes vous permet de comparer des aperçus de CV en image et d’ouvrir un exemple dans l’éditeur. Servez-vous de ces repères pour examiner la hiérarchie des rubriques et la place accordée aux compétences, aux réalisations et à la formation.

  • Des mises en page de CV à comparer
  • Des rubriques faciles à parcourir par les ATS
  • Des mots-clés adaptés à l’ingénierie data AWS
  • Une organisation claire des compétences et de l’expérience
  • Des aperçus visuels de CV
  • Des options pour adapter votre CV

Faites ressortir le lien entre vos choix techniques et leur effet opérationnel : rapprochement des transactions, fiabilité de la facturation, disponibilité des données pour le reporting ou réduction des reprises manuelles. Des formulations précises aident à comprendre la méthode et le résultat sans ajouter de faits non vérifiés.


Voir aussi


Questions fréquentes

Ces modèles de CV de Data Engineer AWS et Python sont-ils adaptés aux ATS ?

Ils privilégient une hiérarchie de rubriques lisible. Pour renforcer la pertinence, reprenez les termes qui correspondent réellement à votre parcours, par exemple Python, PySpark, AWS Glue, AWS Lambda, Athena, SQL, PostgreSQL et pipelines ETL/ELT.

S’agit-il de plusieurs CV différents ?

Le guide présente un exemple de CV décliné en plusieurs mises en page. Comparez les aperçus en image, puis ouvrez l’exemple choisi dans l’éditeur.

Que faut-il inclure dans un CV de Data Engineer AWS et Python ?

Présentez un résumé ciblé, vos expériences, votre formation, vos compétences techniques et vos certifications. Ajoutez des exemples concrets de modélisation, de pipelines, de contrôles qualité, d’optimisation des requêtes et de données préparées pour le reporting ou la BI.

Comment décrire ses réalisations en ingénierie data ?

Utilisez des formulations d’action cohérentes, centrées sur les méthodes et les résultats étayés. Précisez le contexte technique, les données concernées et l’effet observé, sans attribuer de métrique que vous ne pouvez pas justifier.

Comment faire ressortir les compétences AWS et Python ?

Regroupez les outils de façon lisible et reliez-les aux réalisations correspondantes : par exemple, Python et PySpark pour les traitements, AWS Glue pour les pipelines, Athena pour l’analyse et PostgreSQL pour les requêtes et le reporting.

Faut-il ajouter une photo au CV ?

Ajoutez une photo uniquement si elle est habituelle ou demandée dans votre région et votre secteur. En cas de doute, un CV sans photo reste un choix simple et professionnel.

Peut-on personnaliser ces modèles de CV ?

Vous pouvez ouvrir un exemple dans l’éditeur et adapter le CV au poste visé. Veillez à conserver des rubriques claires et à ne retenir que les compétences et résultats qui correspondent à votre parcours.
Score ATS 95%

Comment ce score est calculé

  • Score ATS = arrondi(0,60 × K + 0,20 × T + 0,20 × Q). K : couverture des mots-clés ; T : composante CV textuel (100 pour le CV évalué ici) ; Q : max(0, 100 − déductions des vérifications du CV).
  • Couverture des mots-clés = arrondi(100 × correspondances confirmées ÷ nombre total de mots-clés). Les correspondances exactes et les équivalences étayées validées par l’IA reçoivent tous les points ; les mots-clés non étayés n’en reçoivent aucun. Les vérifications du texte utilisent les équivalences enregistrées sans nouvelle analyse par l’IA. Sans mots-clés, aucun score ATS global n’est disponible.

Ce que signifie ce score

Nos scores sont des estimations, pas des notes d’employeurs. Ils peuvent contenir des erreurs et ne garantissent ni analyse correcte, ni classement, ni entretien, ni emploi. Vérifiez votre document selon les exigences de l’employeur. Vous êtes responsable de l’utilisation de ce score.

Conditions générales

Pondération : mots-clés 60 % · CV textuel 20 % · Qualité du CV 20 %

Couverture des mots-clés : 22 sur 24 (92 %) · Qualité du CV : 100 %

Qualité du CV 100% · Poids 20% · Problèmes (0)

Détails
  • ✓Nom présent: Antoine Denis
  • ✓Format de l’adresse e-mail: antoine.denis@example.com
  • ✓Format du numéro de téléphone: 06 39 98 XX XX
  • ✓Expérience 1: Intitulé du poste: Ingénieur data senior
  • ✓Expérience 1: Nom de l’entreprise: MobiCharge Analytics
  • ✓Expérience 1: Lieu de travail: Lyon
  • ✓Expérience 1: Dates d’emploi: septembre 2022 à présent
  • ✓Expérience 1: Description ou réalisations: Présent
  • ✓Expérience 2: Intitulé du poste: Ingénieur data
  • ✓Expérience 2: Nom de l’entreprise: Sillage Énergies
  • ✓Expérience 2: Lieu de travail: Nantes
  • ✓Expérience 2: Dates d’emploi: janvier 2020 à août 2022
  • ✓Expérience 2: Description ou réalisations: Présent
  • ✓Expérience 3: Intitulé du poste: Développeur data
  • ✓Expérience 3: Nom de l’entreprise: DataRive Conseil
  • ✓Expérience 3: Lieu de travail: Rennes
  • ✓Expérience 3: Dates d’emploi: juillet 2018 à décembre 2019
  • ✓Expérience 3: Description ou réalisations: Présent
  • ✓Expérience 4: Intitulé du poste: Analyste données junior
  • ✓Expérience 4: Nom de l’entreprise: Clairon Énergie
  • ✓Expérience 4: Lieu de travail: Rennes
  • ✓Expérience 4: Dates d’emploi: septembre 2017 à juin 2018
  • ✓Expérience 4: Description ou réalisations: Présent
  • ✓Aucun champ provisoire
  • ✓Aucune réalisation répétée
  • ✓Aucune puce vide

Aucun problème détecté lors des vérifications actuelles.

CV textuel 100% · Poids 20%

Texte extrait
Antoine Denis
Ingénieur data senior
06 39 98 XX XX
antoinedenis
Paris
antoine.denis@example.com
POINTS FORTS
Fiabilité des données
Les contrôles sur les doublons, les montants et les sessions incomplètes ont facilité le diagnostic des écarts de facturation.
Analyse des problèmes
L’examen des plans SQL et des index a permis de cibler les requêtes à optimiser pour les besoins de facturation et de reporting.
Collaboration métier
Les échanges avec les équipes finance, produit et exploitation ont permis de traduire leurs indicateurs en jeux de données BI.
Partage des pratiques
Les revues de code et les conseils de documentation ont accompagné deux ingénieurs juniors dans leurs contributions data.
Documentation traçable
La description des définitions, de la provenance et des contrôles a rendu les jeux de données plus faciles à interpréter.
PROFIL
Ingénieur data spécialisé dans les plateformes AWS, avec neuf ans d’expérience en ingénierie data pour l’énergie, la mobilité électrique et la facturation. Conception de modèles et de pipelines Python et PySpark pour rapprocher les données de recharge, de transaction et de paiement, puis les rendre fiables pour le reporting et la BI. Mise en place de contrôles de qualité, optimisation de requêtes PostgreSQL et documentation de la provenance des données afin de faciliter leur suivi par les équipes finance, produit et opérations. Contribution aux choix d’architecture et aux standards d’équipe, avec accompagnement de deux ingénieurs juniors. Diplômé de l’INSA Rennes et certifié AWS Certified Data Engineer - Associate.
EXPÉRIENCE
Ingénieur data senior
MobiCharge Analytics
septembre 2022 à présent
Lyon
Conception de modèles analytiques pour les sessions de recharge, les transactions et la facturation, avec rapprochement des événements de bornes et des écritures de paiement pour fiabiliser les états de revenus.
Construction de pipelines ETL/ELT en Python et PySpark sur AWS Glue, avec traitements SparkSQL et API DataFrame adaptés aux flux quotidiens de données de recharge.
Structuration du Data Catalog et des tables interrogées dans Amazon Athena, avec documentation des définitions, de la provenance et des contrôles appliqués à chaque étape du cycle de vie des données.
Mise en place de contrôles de qualité portant sur les doublons, les montants incohérents et les sessions incomplètes, facilitant le diagnostic des écarts par les équipes finance et opérations.
Optimisation de requêtes PostgreSQL et SQL pour les usages de facturation et de reporting, avec analyse des plans d’exécution et révision des index sur les tables transactionnelles.
Développement de fonctions AWS Lambda pour valider et acheminer des événements opérationnels, réduisant les reprises manuelles lors des incidents de flux.
Traduction des besoins des équipes produit, finance et exploitation en jeux de données pour la BI, avec documentation des indicateurs et présentation des arbitrages d’architecture à l’équipe data.
Accompagnement de deux ingénieurs data dans les revues de code Python et la mise en pratique des standards de documentation et de qualité.
Ingénieur data
Sillage Énergies
janvier 2020 à août 2022
Nantes
Développement de traitements PySpark et Python pour rapprocher les données de comptage énergétique, les contrats clients et les opérations de facturation dans un environnement AWS.
Orchestration de pipelines ETL avec AWS Glue et interrogations de grands jeux de données avec Athena, en séparant les données brutes, contrôlées et prêtes pour l’analyse.
Optimisation de requêtes SQL et PostgreSQL pour accélérer la production de rapports mensuels destinés aux équipes financières et aux responsables d’exploitation.
Formalisation des règles de qualité et des définitions de données avec les analystes métiers, améliorant la traçabilité des corrections et la cohérence des livrables BI.
Développeur data
DataRive Conseil
juillet 2018 à décembre 2019
Rennes
Création de traitements Python et SQL pour consolider des historiques de consommation et des fichiers de facturation issus de plusieurs systèmes clients.
Conception de tables PostgreSQL dédiées au reporting, avec contrôles de cohérence et documentation des champs pour simplifier les analyses récurrentes.
Préparation de jeux de données et de tableaux de bord pour des équipes d’exploitation, en clarifiant les définitions d’indicateurs avec les utilisateurs.
Analyste données junior
Clairon Énergie
septembre 2017 à juin 2018
Rennes
Préparation de jeux de données SQL pour le suivi de contrats et de consommations, avec vérification des doublons et signalement des anomalies avant publication des rapports.
Automatisation de consolidations récurrentes en Python et documentation des règles de transformation, réduisant les corrections manuelles lors des clôtures mensuelles.
COMPÉTENCES
Collaboration métier
Optimisation SQL
Documentation des données
Modélisation des données
Gestion des transactions
Données de facturation
Données de recharge
Qualité des données
Analyse de données
Mentorat technique
Pipelines ETL/ELT
Ingénierie data
Reporting et BI
Architecture data
Revue de code
LANGUES
Français
Langue maternelle
Anglais
Niveau professionnel
RESPONSABILITÉS, DISTINCTIONS ET RECONNAISSANCE
Mentorat de deux ingénieurs juniors chez MobiCharge Analytics, avec revues de code et partage de pratiques de documentation des données.
Reconnaissance interne en 2024 pour la fiabilisation des données de facturation et la qualité de la documentation associée.
FORMATION
Diplôme d’ingénieur en informatique et systèmes d’information, niveau Bac+5
INSA Rennes
2017
Rennes
CERTIFICATIONS
AWS Certified Data Engineer - Associate
2025
Formation en qualité et gouvernance des données
2024
COMPÉTENCES TECHNIQUES
Langages de programmation: Python, SQL, Scala
Traitement distribué: PySpark, Apache Spark, SparkSQL
Services AWS de traitement: AWS Glue, AWS Lambda, AWS Step Functions
Catalogue et analyse AWS: AWS Glue Data Catalog, Amazon Athena, Amazon EMR
Bases de données relationnelles: PostgreSQL, MySQL, Amazon Aurora
Stockage de données AWS: Amazon S3, Amazon Redshift, AWS Lake Formation
Outils de traitement de données: Apache Parquet, Apache Avro, Apache ORC
Formats et échange de données: JSON, CSV, Apache Arrow
Outils de développement Python: pandas, NumPy, boto3
Contrôle de versions et livraison: Git, Docker, Jenkins
AFFILIATIONS PROFESSIONNELLES
Membre de France Data Network, participation aux échanges professionnels autour des pratiques de traitement et de gouvernance des données.
Membre de l’association Data for Good, contribution aux échanges de la communauté sur l’usage responsable des données.

Mots-clés correspondants (22)

  • Diplôme d’ingénieur en informatique et systèmes d’information, niveau Bac+5Mot-clé original dans l’offre: Formation de niveau Bac+5
  • neuf ans d’expérience en ingénierie dataMot-clé original dans l’offre: 7+ ans d’expérience en ingénierie data
  • Python
  • PySpark
  • SparkSQL
  • API DataFrame
  • AWS Glue
  • AWS Glue Data Catalog
  • AWS Lambda
  • Amazon Athena
  • Pipelines ETL/ELT
  • SQL
  • PostgreSQL
  • optimisation de requêtes PostgreSQLMot-clé original dans l’offre: Optimisation des requêtes PostgreSQL
  • Modélisation des données
  • Architecture data
  • Qualité des données
  • documentation des définitions, de la provenance et des contrôles appliqués à chaque étape du cycle de vie des donnéesMot-clé original dans l’offre: Documentation du cycle de vie des données
  • Traduction des besoins des équipes produit, finance et exploitation en jeux de données pour la BIMot-clé original dans l’offre: Traduction des besoins des parties prenantes en solutions data
  • mobilité électrique
  • Données de recharge
  • Conception de modèles analytiques pour les sessions de recharge, les transactions et la facturationMot-clé original dans l’offre: Données de transactions et de facturation

Mots-clés manquants (2)

  • Standards et bonnes pratiques data
  • Jeux de données pour le reporting et la BI
Avertissement : Tous les noms, images, coordonnées, parcours professionnels, réalisations, habilitations de sécurité, titres militaires et autres qualifications présentés dans ce contenu sont fictifs et utilisés uniquement à des fins d’illustration. Toute ressemblance avec des personnes réelles, vivantes ou décédées, est purement fortuite.

Les exemples de CV et de lettres de motivation et les recommandations de cet article reflètent des bonnes pratiques générales et une expérience professionnelle et sont fournis à titre indicatif uniquement. Les résultats peuvent varier selon le poste, le secteur, la région et l’organisation recruteuse.

Exactitude et vérification du contenu : Dans toute la mesure permise par la loi applicable, nous ne déclarons ni ne garantissons que les conseils, exemples, recommandations ou informations connexes concernant les CV ou lettres de motivation sont exacts, complets, à jour, exempts d’erreurs ou adaptés à un usage particulier. Il vous appartient d’examiner et de vérifier ces informations de manière indépendante avant de vous y fier.

Scores ATS et de lettre de motivation : Les scores ATS sont des estimations calculées selon notre propre formule, fondée sur des conseils accessibles au public concernant la mise en forme des CV et la correspondance des mots-clés. Ils ne sont ni attribués ni approuvés par un fournisseur ATS ou un employeur. Les scores des lettres de motivation sont également nos propres évaluations. L’analyse, la pondération, les critères de sélection et les résultats varient selon les systèmes, les employeurs, les offres et les formats de documents. Aucun score ne garantit une analyse correcte, un classement, un entretien ou un emploi. Utilisez ces scores à titre indicatif et vérifiez vous-même vos documents au regard des exigences de l’employeur. Dans toute la mesure permise par la loi applicable, nous déclinons toute responsabilité pour les erreurs de score ou d’analyse, ou les pertes résultant de la confiance accordée à ces évaluations. Le présent avis n’exclut aucune responsabilité et ne limite aucun droit des consommateurs qui ne peut légalement être exclu ou limité.

Conditions générales
 
> JP 1 1
Configuration des pieds de page et des marges PDF
Les marges sont appliquées au document et le pied de page apparaît à la fois dans l’aperçu et le PDF

Paramètres de la police du pied de page

Postulez-vous à un poste spécifique
afin que nous puissions adapter votre CV en conséquence ?
Postulez-vous à un poste spécifique
afin que nous puissions adapter votre lettre de motivation en conséquence ?

Vos données restent privées et ne sont jamais utilisées à des fins d’entraînement.Politique de confidentialité

Saisissez vos informations sous forme de texte pour générer un CV personnalisé Saisissez vos informations en texte pour générer une lettre de motivation personnalisée
Lien du site trouvé ! Prêt à créer le CV à partir de :

Vos données restent privées et ne sont jamais utilisées à des fins d’entraînement.Politique de confidentialité

Faites glisser le dans la boîte pour vérifier que vous n'êtes pas un robot.
Déposez ici

Mes CV

Affichage de {number_of_files} fichiers (sur un total de {total_of_all_files})
Nom du fichier Type de fichier Dernière modification : Description :

Renommer le fichier

Nom de fichier déjà existant !

Supprimer les fichiers

Avertissement : Cette action est irréversible. Une fois validé, les fichiers seront définitivement supprimés.

Heading text
Téléverser depuis l’ordinateur Téléverser
Sélectionner parmi les existants
LinkedIn
Glissez-déposez des fichiers n’importe où dans cet onglet, ou

Fichiers téléversés

Supprimer Nom du fichier Dernière mise à jour Utiliser ce fichier
Sélectionnez ceci pour utiliser le fichier pour générer votre CV et lettre de motivation. Une seule source — fichier téléversé, fichier sélectionné ou texte LinkedIn — peut être utilisée.

Fichiers

Les CV ou lettres de motivation que vous créez apparaîtront ici. Aucun fichier disponible pour le moment.
Supprimer Nom du fichier Dernière mise à jour Utiliser ce fichier
Sélectionnez ceci pour utiliser le fichier pour générer votre CV et lettre de motivation. Une seule source — fichier téléversé, fichier sélectionné ou texte LinkedIn — peut être utilisée.

Ajouter le PDF de votre profil LinkedIn

Vous pouvez télécharger votre profil LinkedIn au format PDF en ouvrant linkedin.com dans un navigateur, en cliquant sur votre photo de profil, en sélectionnant « Plus » ou « Ressources » puis « Enregistrer au format PDF ». Vous pourrez ensuite joindre le PDF via l’onglet Télécharger depuis l’ordinateur.

Collez le texte de votre profil LinkedIn

Si vous avez copié le texte de votre profil LinkedIn, collez-le ci-dessous. Voir comment copier votre profil sur LinkedIn

Sélectionnez cette option pour utiliser le texte de profil LinkedIn pour générer votre CV et votre lettre de motivation. Une seule source peut être utilisée—fichier téléchargé, sélectionné ou texte LinkedIn.

Essayez ces commandes

<
>