Anglais US


7 modèles de CV pour Data Scientist - Python et PySpark, avec exemples
Par Ria · Dernière mise à jour le 19 octobre 2026
Exemple de CV — page 1

Ce guide pratique vous aide à créer un CV de Data Scientist - Python et PySpark clair, ciblé et facile à parcourir. Vous y trouverez des repères pour organiser vos compétences, vos expériences et vos résultats, ainsi que pour comparer différentes présentations professionnelles.

Pour ce rôle, reliez les analyses exploratoires, les études statistiques et le Machine Learning à leur mise en production. Faites ressortir les usages de Python et PySpark, les environnements Hadoop et PostgreSQL, les contrôles qualité, ainsi que la restitution des résultats avec Power BI.

L’exemple est présenté en 7 mises en page. Comparez les aperçus image et leurs choix de structure : le modèle Compact place les coordonnées dans l’en-tête, avec les compétences et les points forts dans une barre latérale à côté du parcours professionnel.

Qu’est-ce qui fait un bon CV de Data Scientist - Python et PySpark en 2026 ?

Un CV efficace hiérarchise les expériences, les compétences et les résultats pertinents pour le poste. Des rubriques explicites et des formulations courtes facilitent le repérage des informations par les recruteurs et les ATS.

Décrivez vos contributions avec des groupes nominaux d’action cohérents, les méthodes employées et les résultats vérifiables. Intégrez naturellement les mots-clés justifiés par votre parcours, comme Python, PySpark, Hadoop, PostgreSQL, Scikit-learn, XGBoost et GitLab CI/CD.

Note : Les exemples de CV sont fournis à titre pédagogique uniquement. Utilisez uniquement des informations qui reflètent fidèlement votre expérience et vos qualifications. Les références à des organisations réelles n’impliquent aucune affiliation ni approbation de leur part.

#1 Compact (format sobre à deux colonnes avec photo)

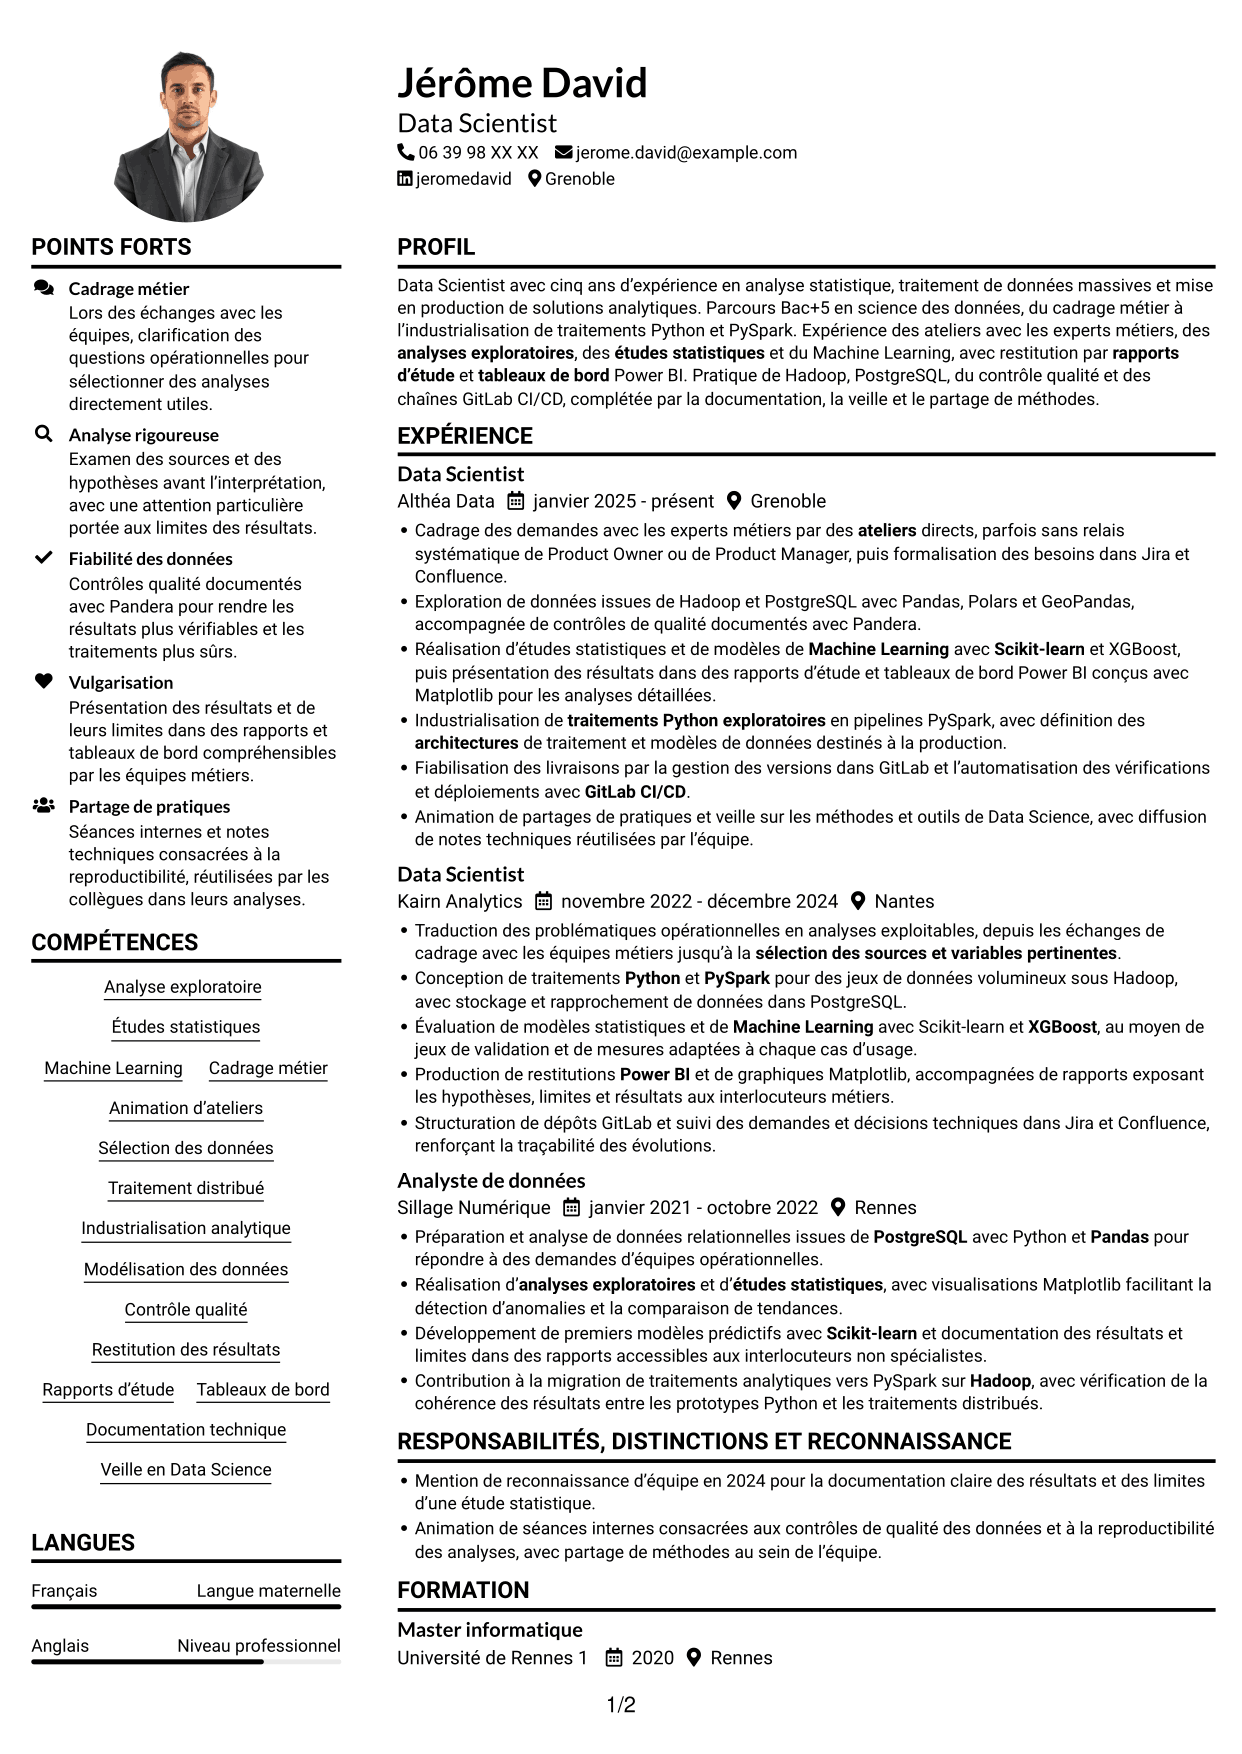
Compact associe une page blanche, deux colonnes et une photo en haut à gauche ; ses séparateurs fins conviennent à une présentation sobre où le texte garde une place importante.
 
CV Compact (format sobre à deux colonnes avec photo) : Data Scientist - Python et PySpark, page 1   CV Compact (format sobre à deux colonnes avec photo) : Data Scientist - Python et PySpark, page 2

Pourquoi choisir ce modèle ?

  • Les deux colonnes distinguent les rubriques et facilitent le parcours entre expérience et compétences.
  • Les séparateurs fins marquent les transitions entre formation, certifications et expérience professionnelle.
  • La place laissée au texte permet de détailler le parcours sans gêner le repérage.

À privilégier pour

  • CV à nombreuses rubriques
  • Parcours professionnel détaillé
  • Repérage rapide des compétences
  • Présentation sobre avec portrait
  • Lecture parallèle de contenus complémentaires

Mots-clés du CV

  • Master informatique
  • cinq ans d’expérience en analyse statistique, traitement de données massives et mise en production de solutions analytiques
  • Python
  • PySpark
  • analyses exploratoires
  • Études statistiques
  • Machine Learning
  • Cadrage des demandes avec les experts métiers par des ateliers directs
  • sélection des sources et variables pertinentes
  • Industrialisation de traitements Python exploratoires en pipelines PySpark
  • définition des architectures de traitement et modèles de données destinés à la production
  • Modélisation des données
  • Rapports d’étude
  • tableaux de bord
  • Power BI
Voir tous les mots-clés
 

#2 Élégant (format à colonne latérale colorée avec photo)

Élégant place la photo et les informations complémentaires dans une colonne latérale bleue, tandis que le contenu principal reste sur fond blanc pour rendre les deux zones immédiatement distinctes.
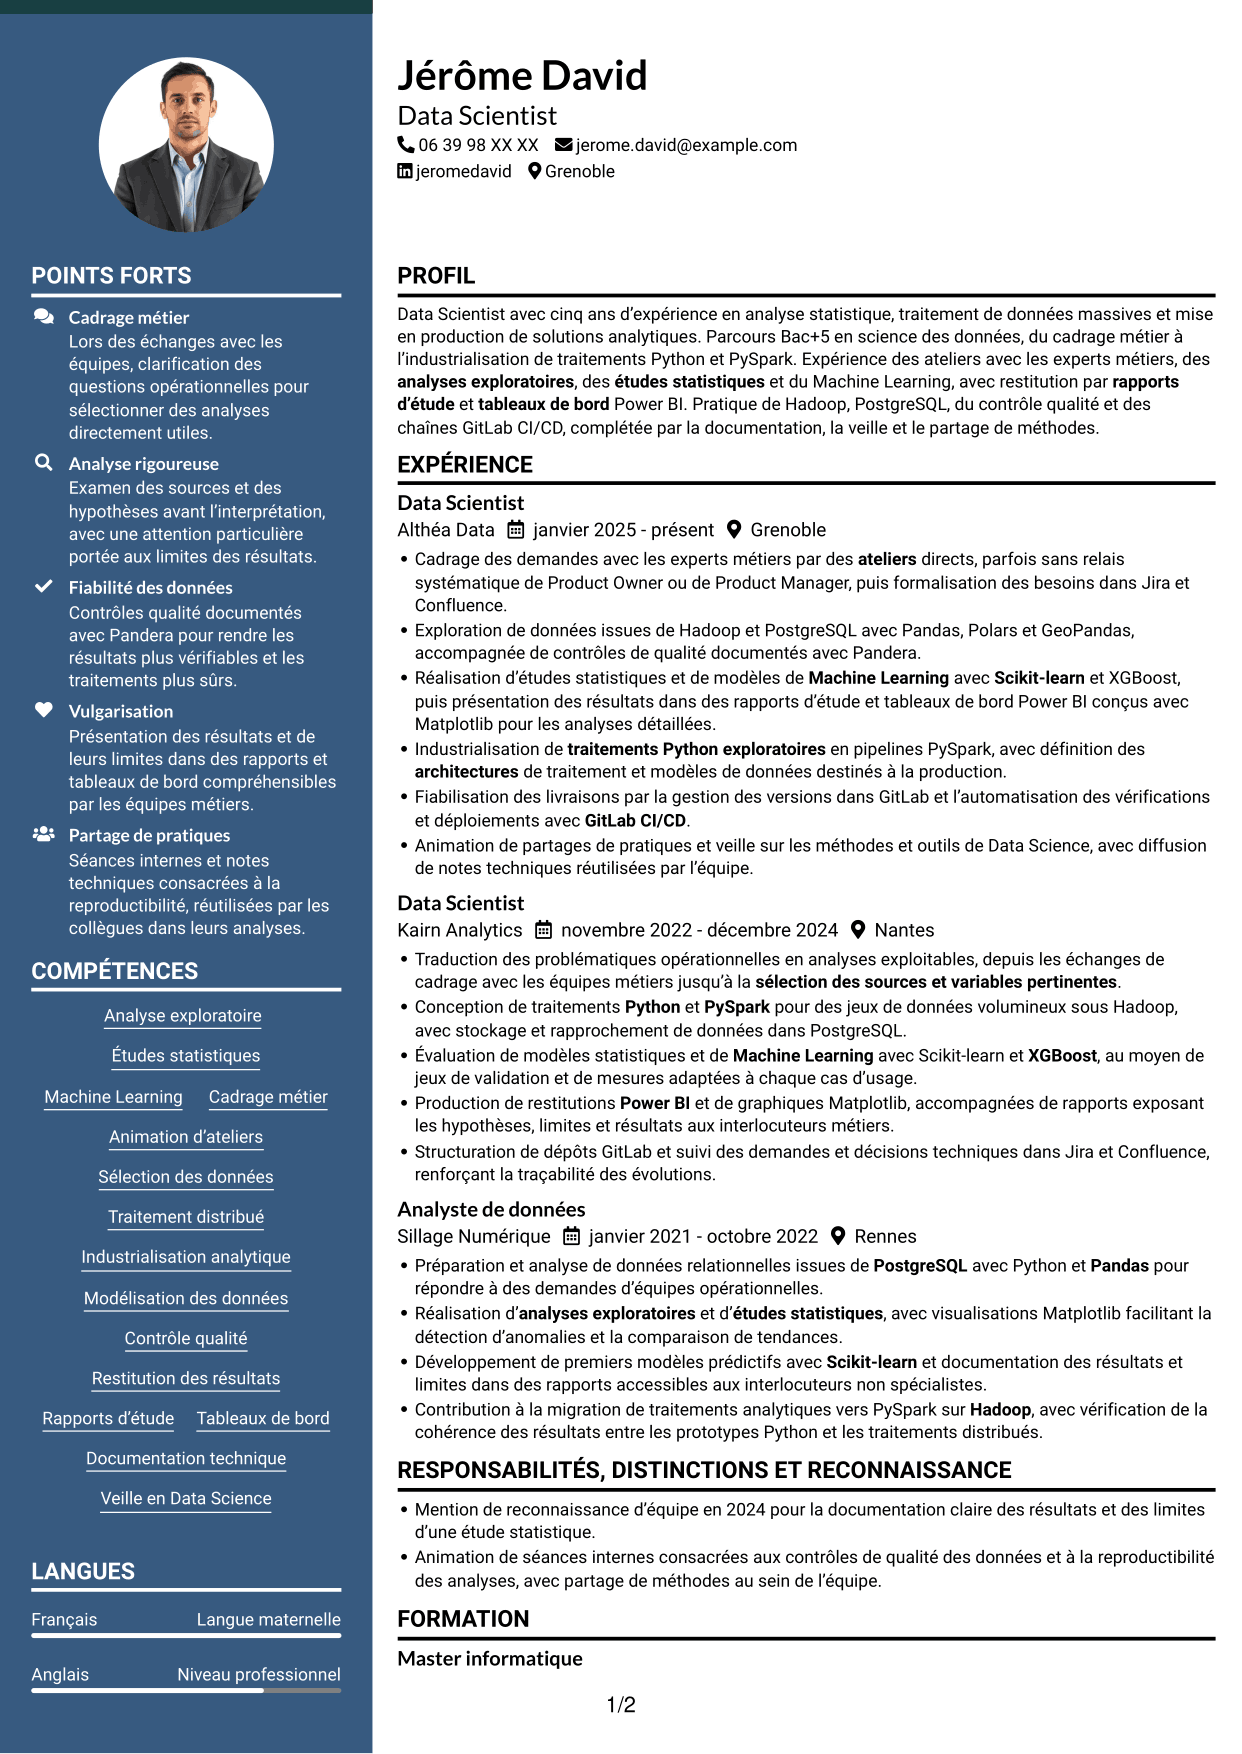
 
CV Élégant (format à colonne latérale colorée avec photo) : Data Scientist - Python et PySpark, page 1   CV Élégant (format à colonne latérale colorée avec photo) : Data Scientist - Python et PySpark, page 2

Pourquoi choisir ce modèle ?

  • La colonne bleue distingue les informations complémentaires du contenu principal sur fond blanc.
  • Le contraste des deux zones aide à suivre le parcours et ses étapes.
  • Les rubriques de compétences et de formation restent repérables dans une structure équilibrée.

À privilégier pour

  • Séparation des informations complémentaires
  • Parcours à étapes distinctes
  • CV avec portrait latéral
  • Rubriques de compétences et formation
  • Contraste visuel entre les zones
 

#3 Moderne (format à deux colonnes avec photo à gauche et séparateur)

Moderne combine une photo arrondie à gauche, un séparateur entre les deux colonnes et des titres soulignés, pour offrir des repères visuels nets sans multiplier les ornements.
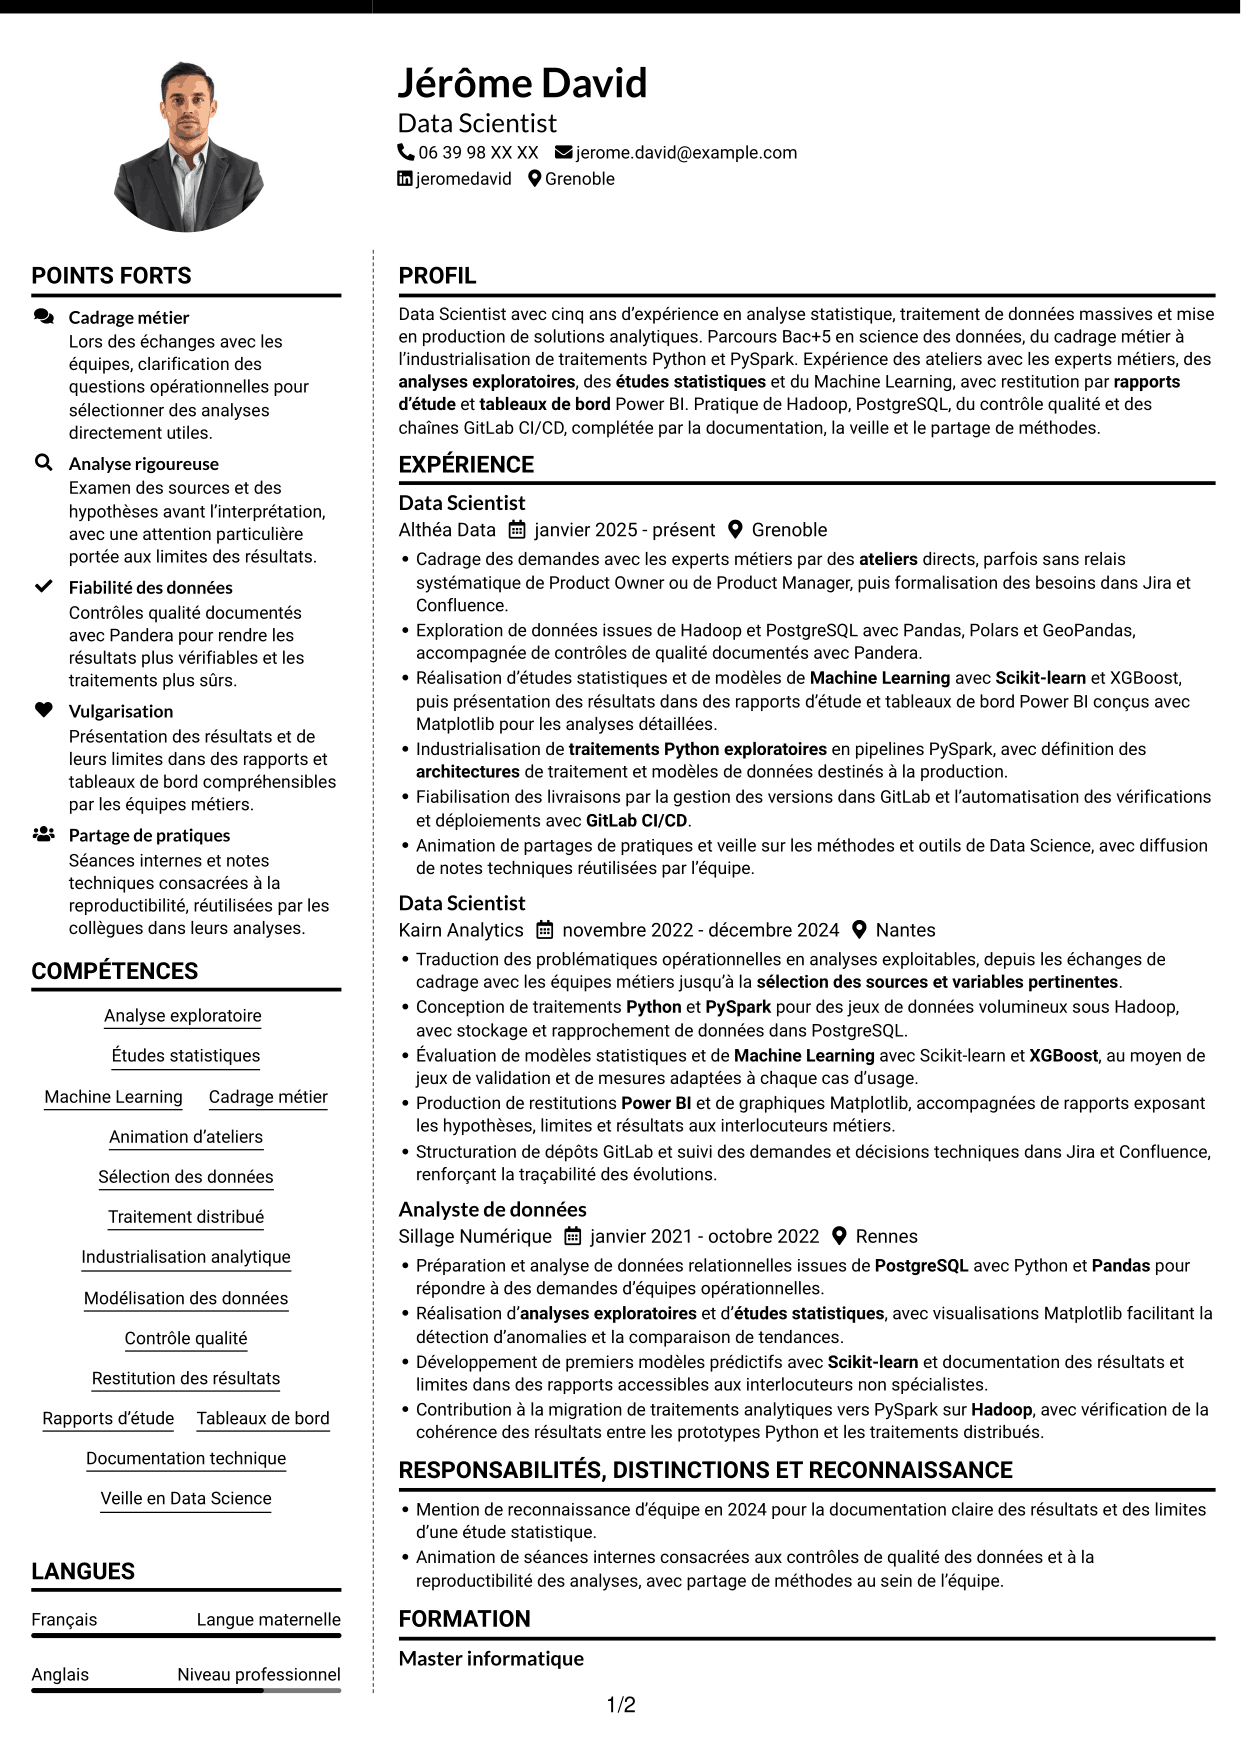
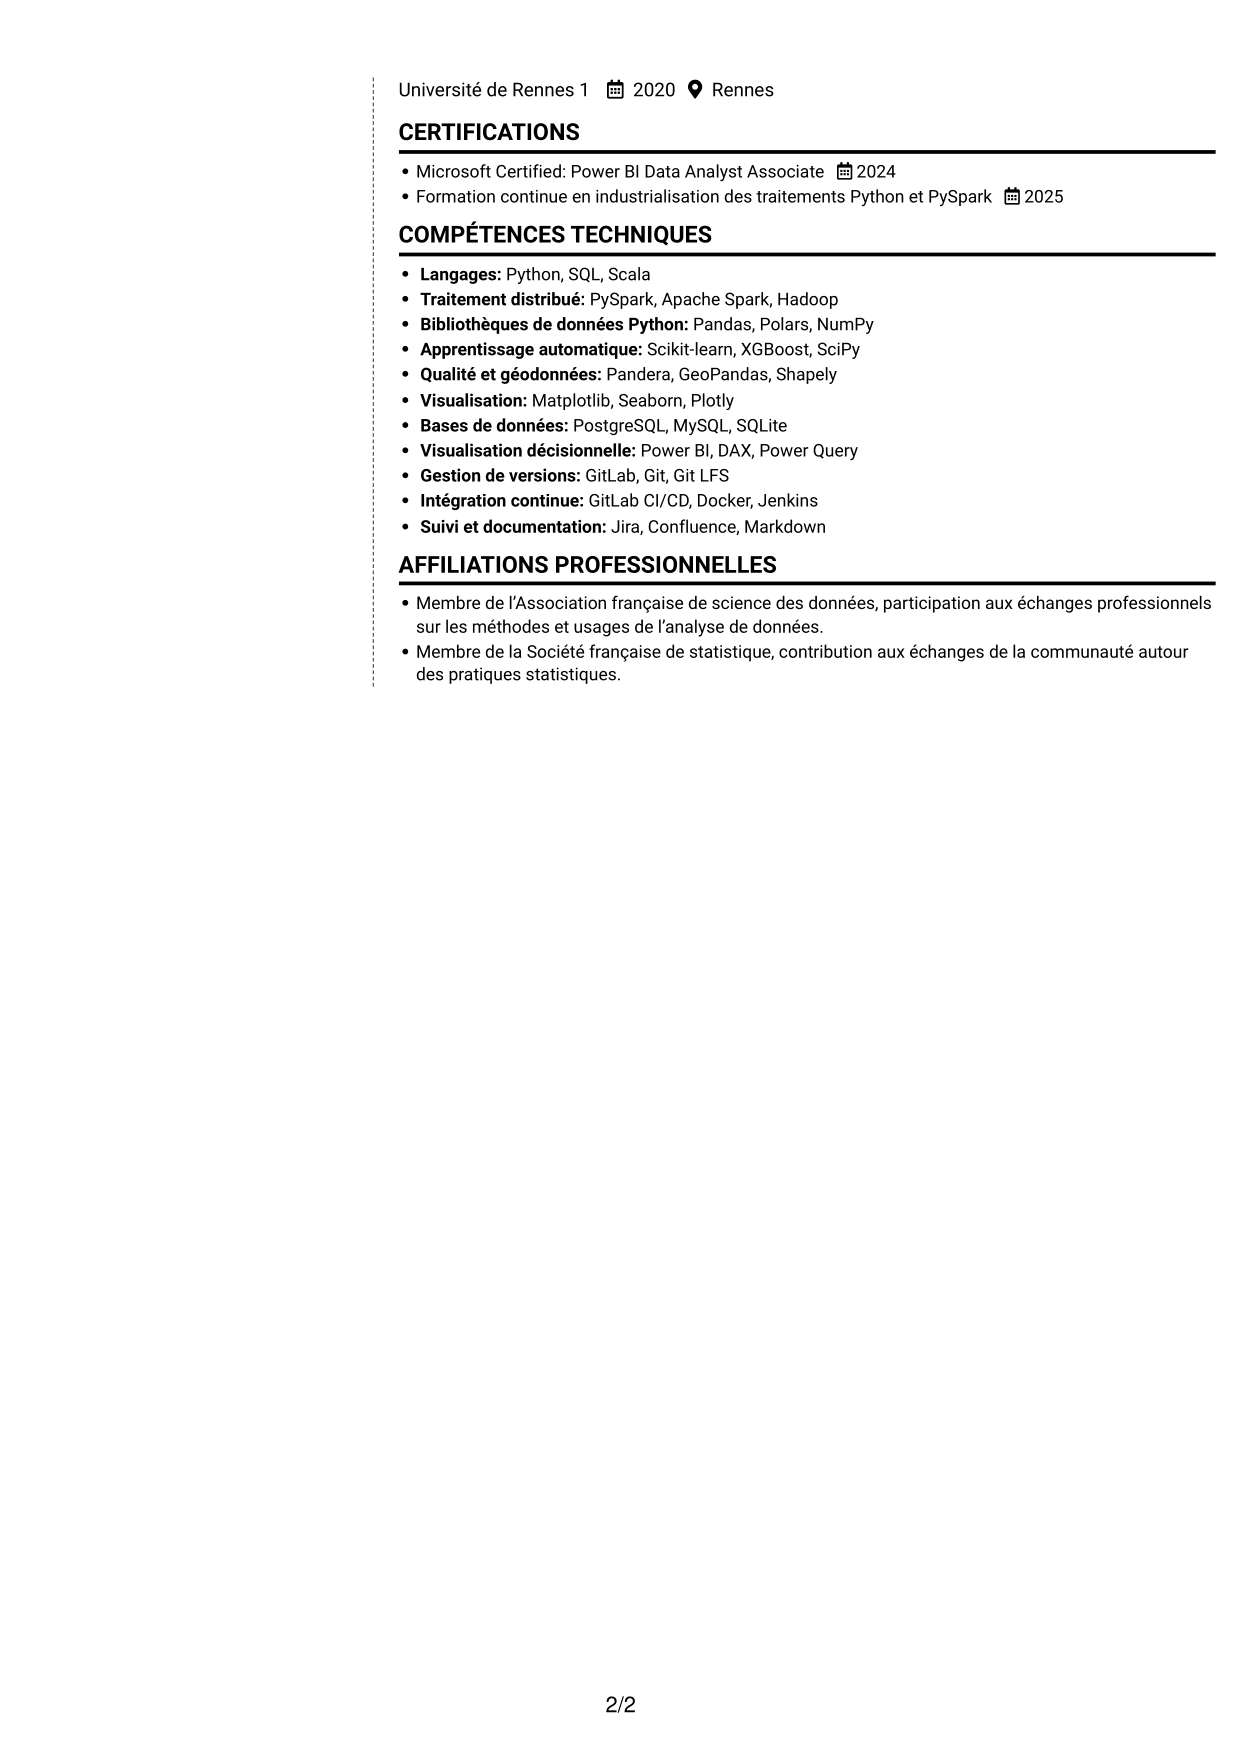
 
CV Moderne (format à deux colonnes avec photo à gauche et séparateur) : Data Scientist - Python et PySpark, page 1   CV Moderne (format à deux colonnes avec photo à gauche et séparateur) : Data Scientist - Python et PySpark, page 2

Pourquoi choisir ce modèle ?

  • Le séparateur clarifie la relation entre les colonnes sans interrompre le balayage du CV.
  • Les titres soulignés aident à retrouver expérience, formation et compétences dans les rubriques.
  • Le fond blanc et les ornements limités laissent le texte au premier plan.

À privilégier pour

  • Repères visuels par rubrique
  • Lecture de parcours en deux colonnes
  • Présentation avec portrait arrondi
  • CV à décoration discrète
  • Accès direct aux sections principales
 

#4 Audacieux (format à deux colonnes avec accents colorés et photo)

Audacieux reprend une couleur d’accent dans le liseré supérieur, le nom, les icônes et les titres ; ses deux colonnes conservent une lecture structurée sur fond blanc.
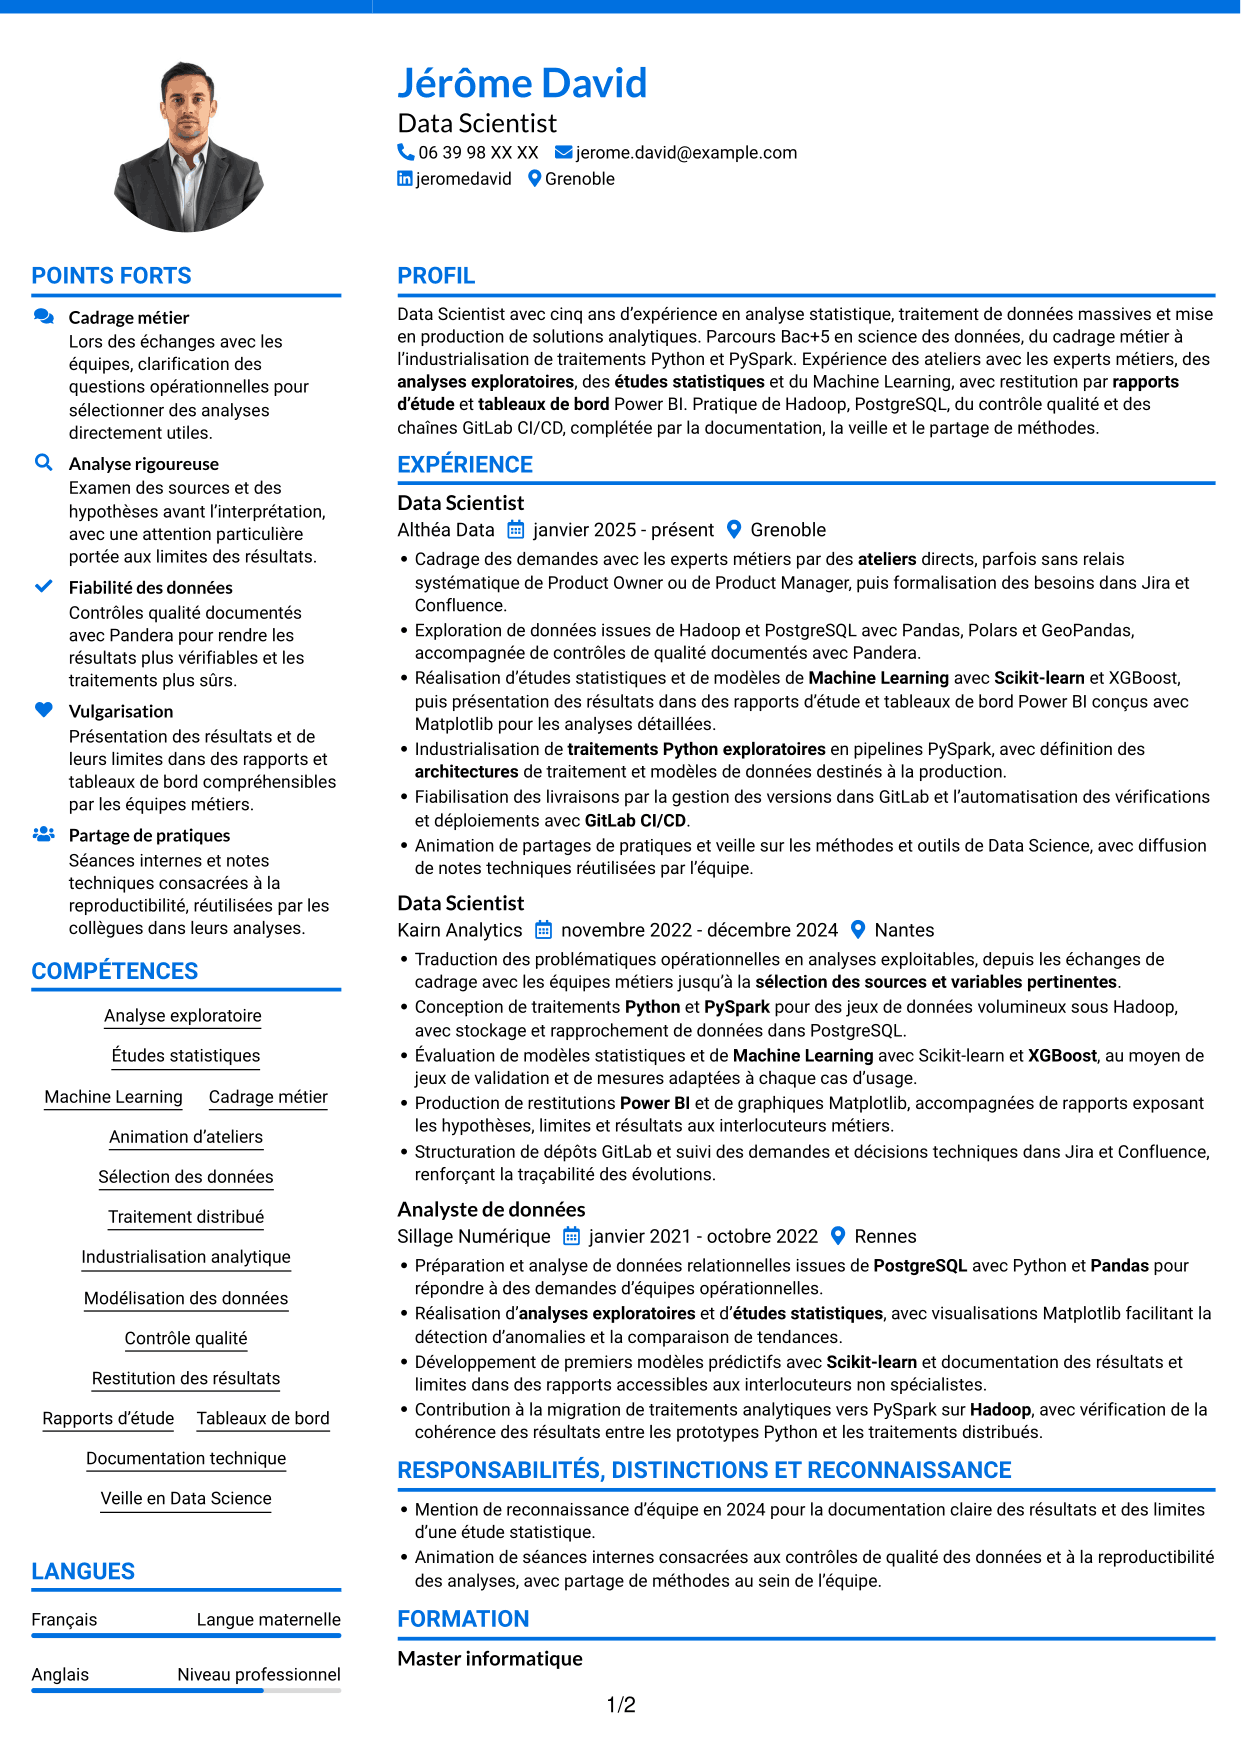
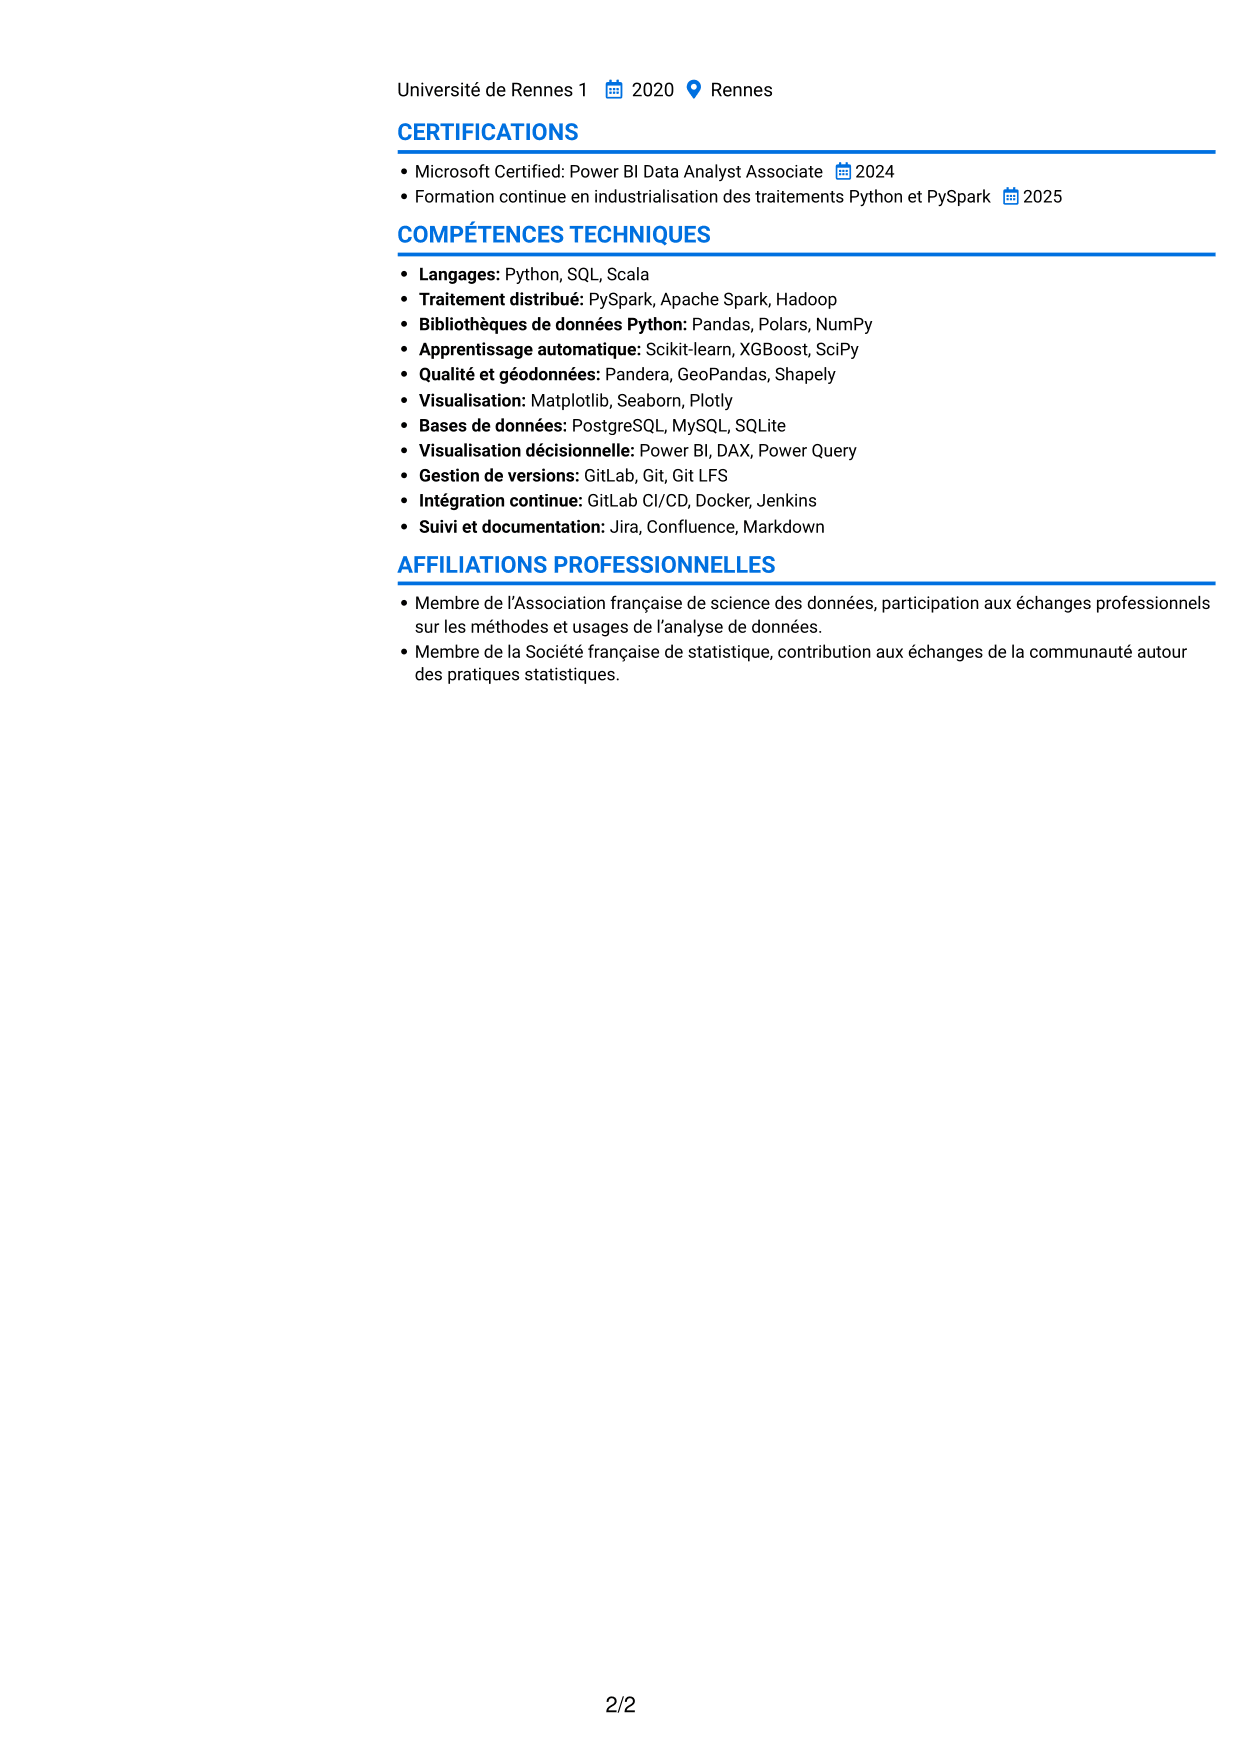
 
CV Audacieux (format à deux colonnes avec accents colorés et photo) : Data Scientist - Python et PySpark, page 1   CV Audacieux (format à deux colonnes avec accents colorés et photo) : Data Scientist - Python et PySpark, page 2

Pourquoi choisir ce modèle ?

  • Les accents colorés hiérarchisent les titres et facilitent le repérage des rubriques.
  • Le liseré supérieur et le nom coloré créent un point d’entrée visuel identifiable.
  • Les deux colonnes permettent de parcourir expérience et informations complémentaires côte à côte.

À privilégier pour

  • Titres de rubriques bien visibles
  • CV avec photo et accents colorés
  • Parcours associé à des informations complémentaires
  • Lecture côte à côte des rubriques
  • Présentation plus expressive sur fond blanc


#5 Signature (format à colonne latérale colorée avec grande photo)

Signature associe une grande photo rectangulaire en haut d’une colonne latérale colorée au contenu principal sur fond blanc, pour une présentation où le portrait occupe une place marquée.
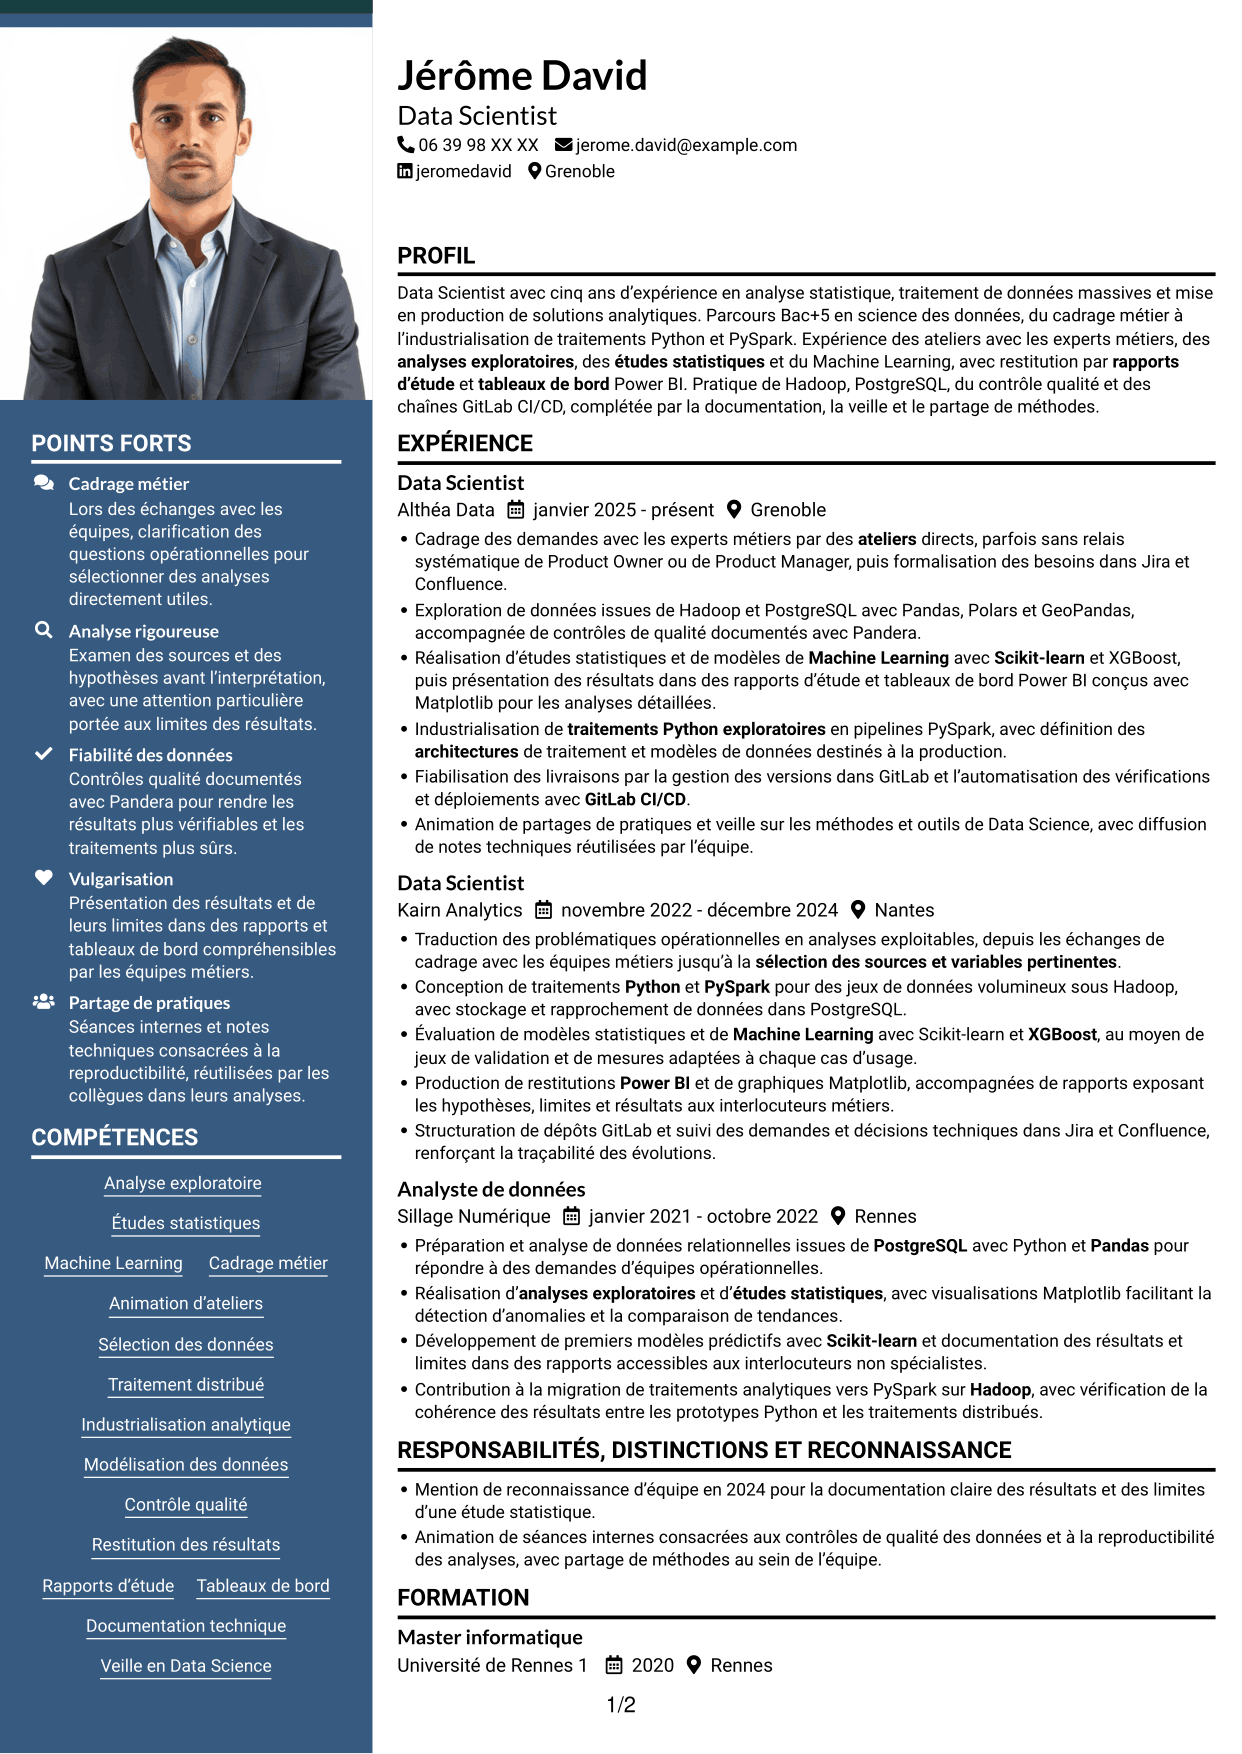
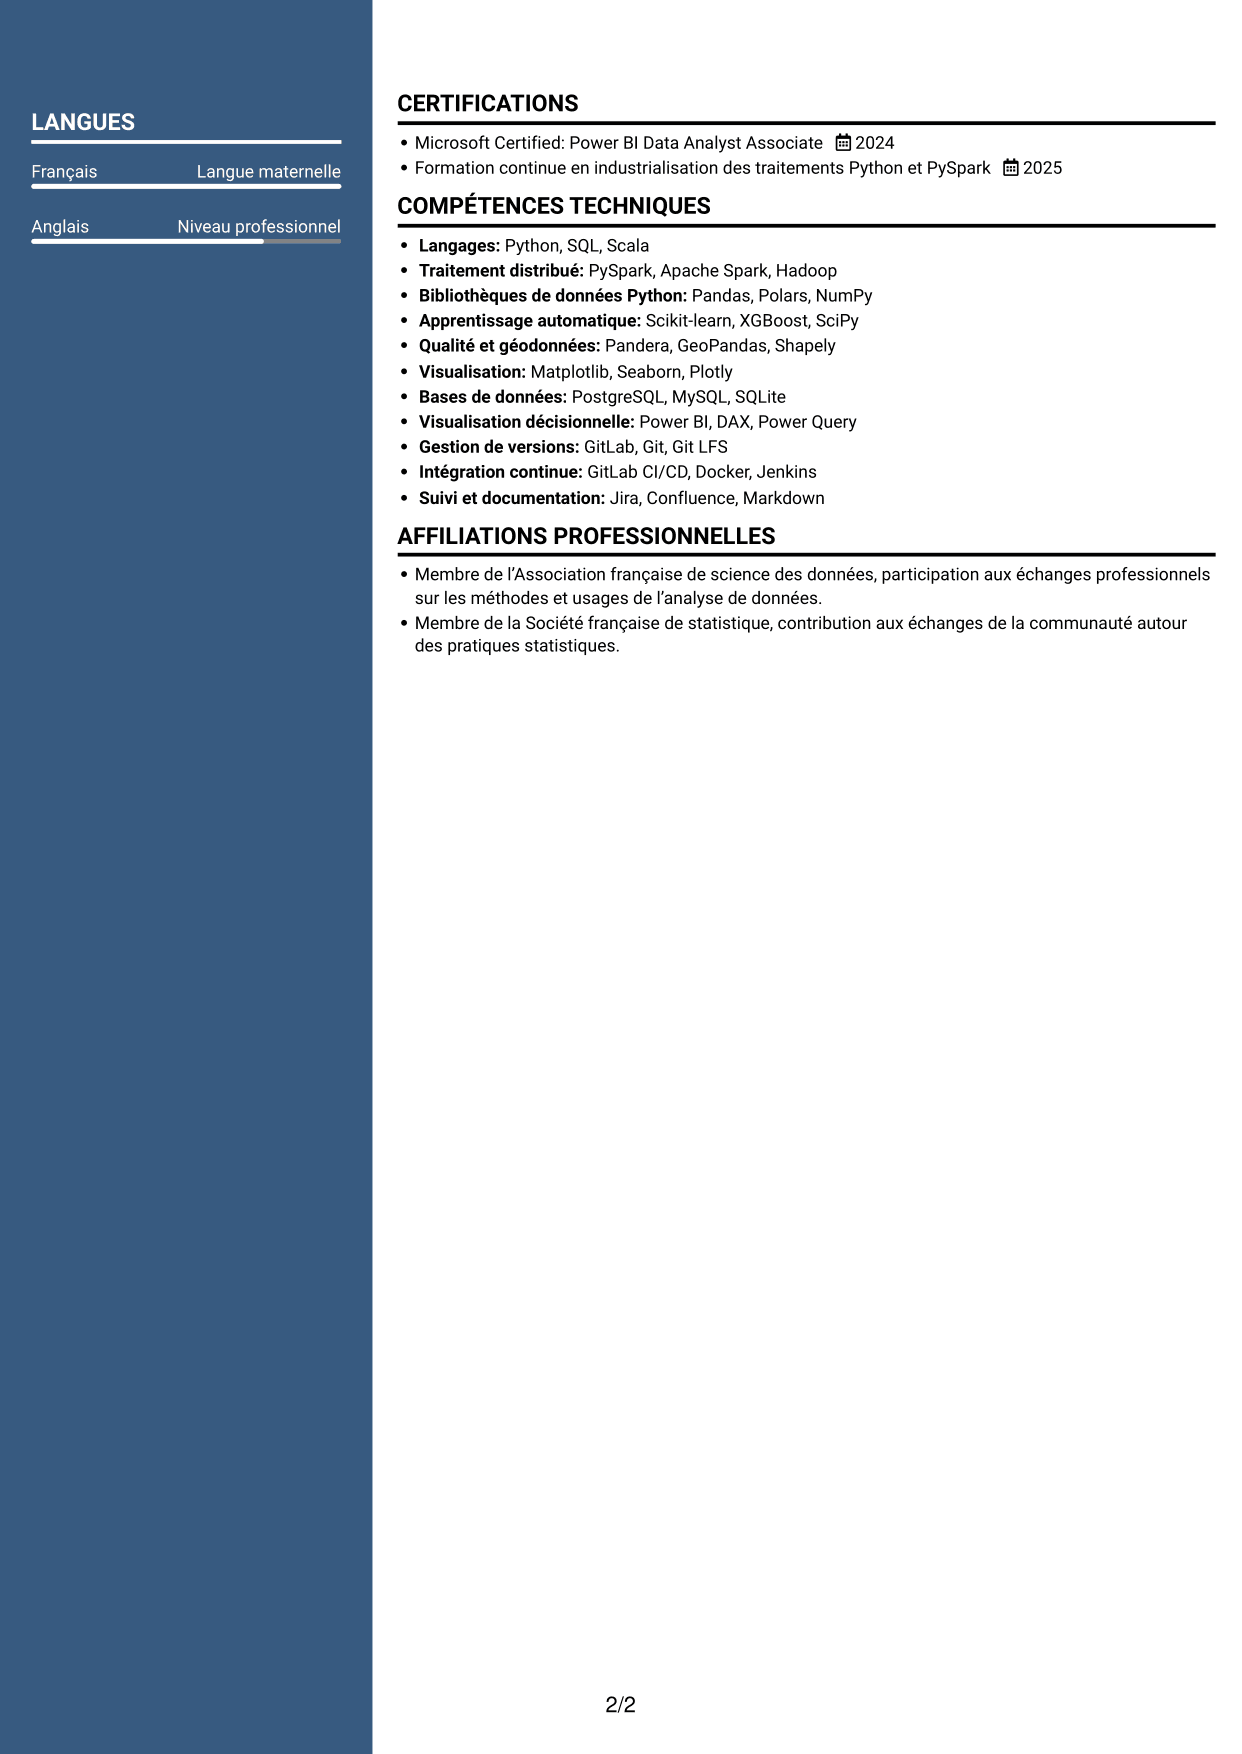
 
CV Signature (format à colonne latérale colorée avec grande photo) : Data Scientist - Python et PySpark, page 1   CV Signature (format à colonne latérale colorée avec grande photo) : Data Scientist - Python et PySpark, page 2

Pourquoi choisir ce modèle ?

  • La colonne latérale colorée sépare les informations complémentaires du parcours détaillé sur fond blanc.
  • La grande photo affirme une présence visuelle sans modifier l’ordre des rubriques.
  • Le contraste des zones aide à distinguer compétences, formation et expériences professionnelles.

À privilégier pour

  • Portrait de grande taille
  • Informations complémentaires en colonne latérale
  • Parcours détaillé sur fond blanc
  • Rubriques distinctes de compétences et formation
  • Présentation visuelle marquée
 

#6 Fonceur (format à deux colonnes avec en-tête centré sans photo)

Fonceur présente un en-tête centré où les coordonnées sont encadrées ; sans photo, il associe une colonne latérale légèrement teintée au contenu principal en deux colonnes.
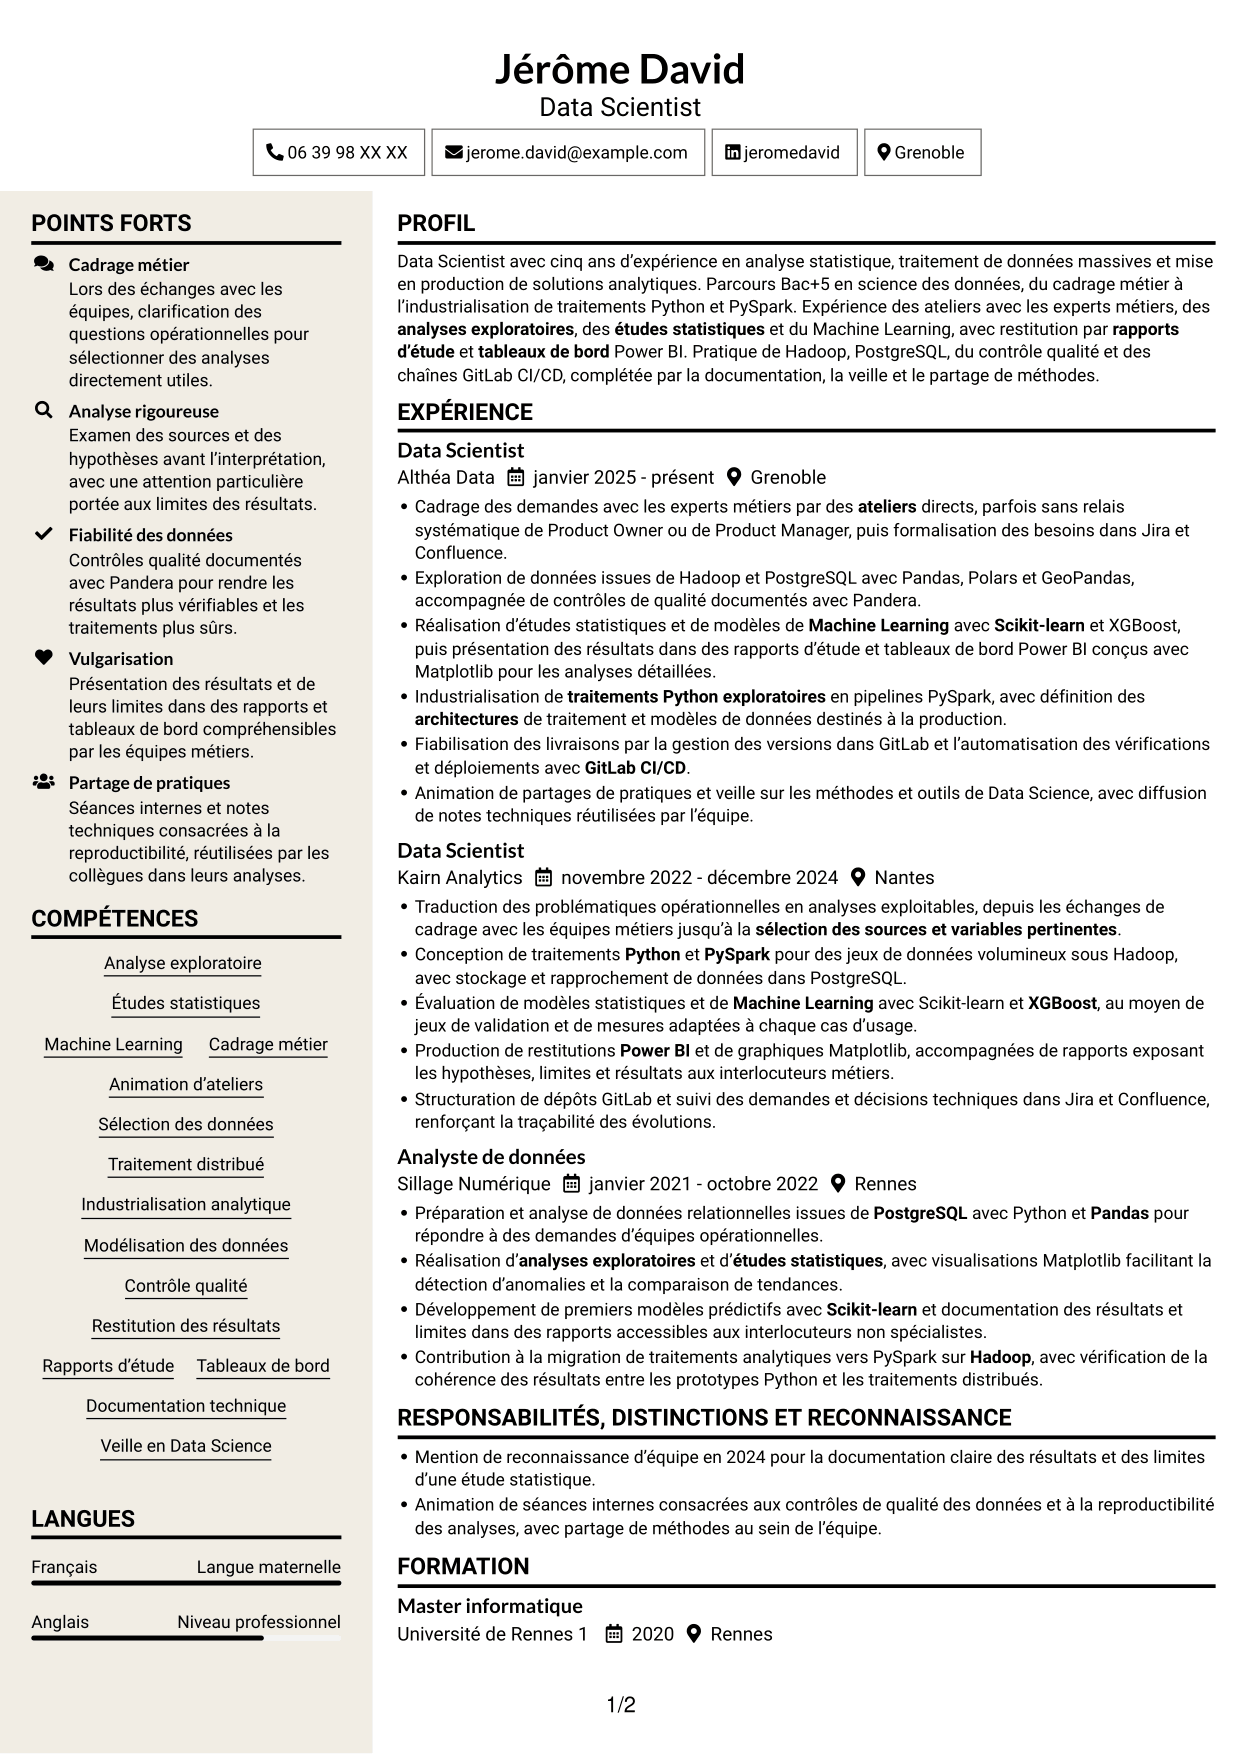
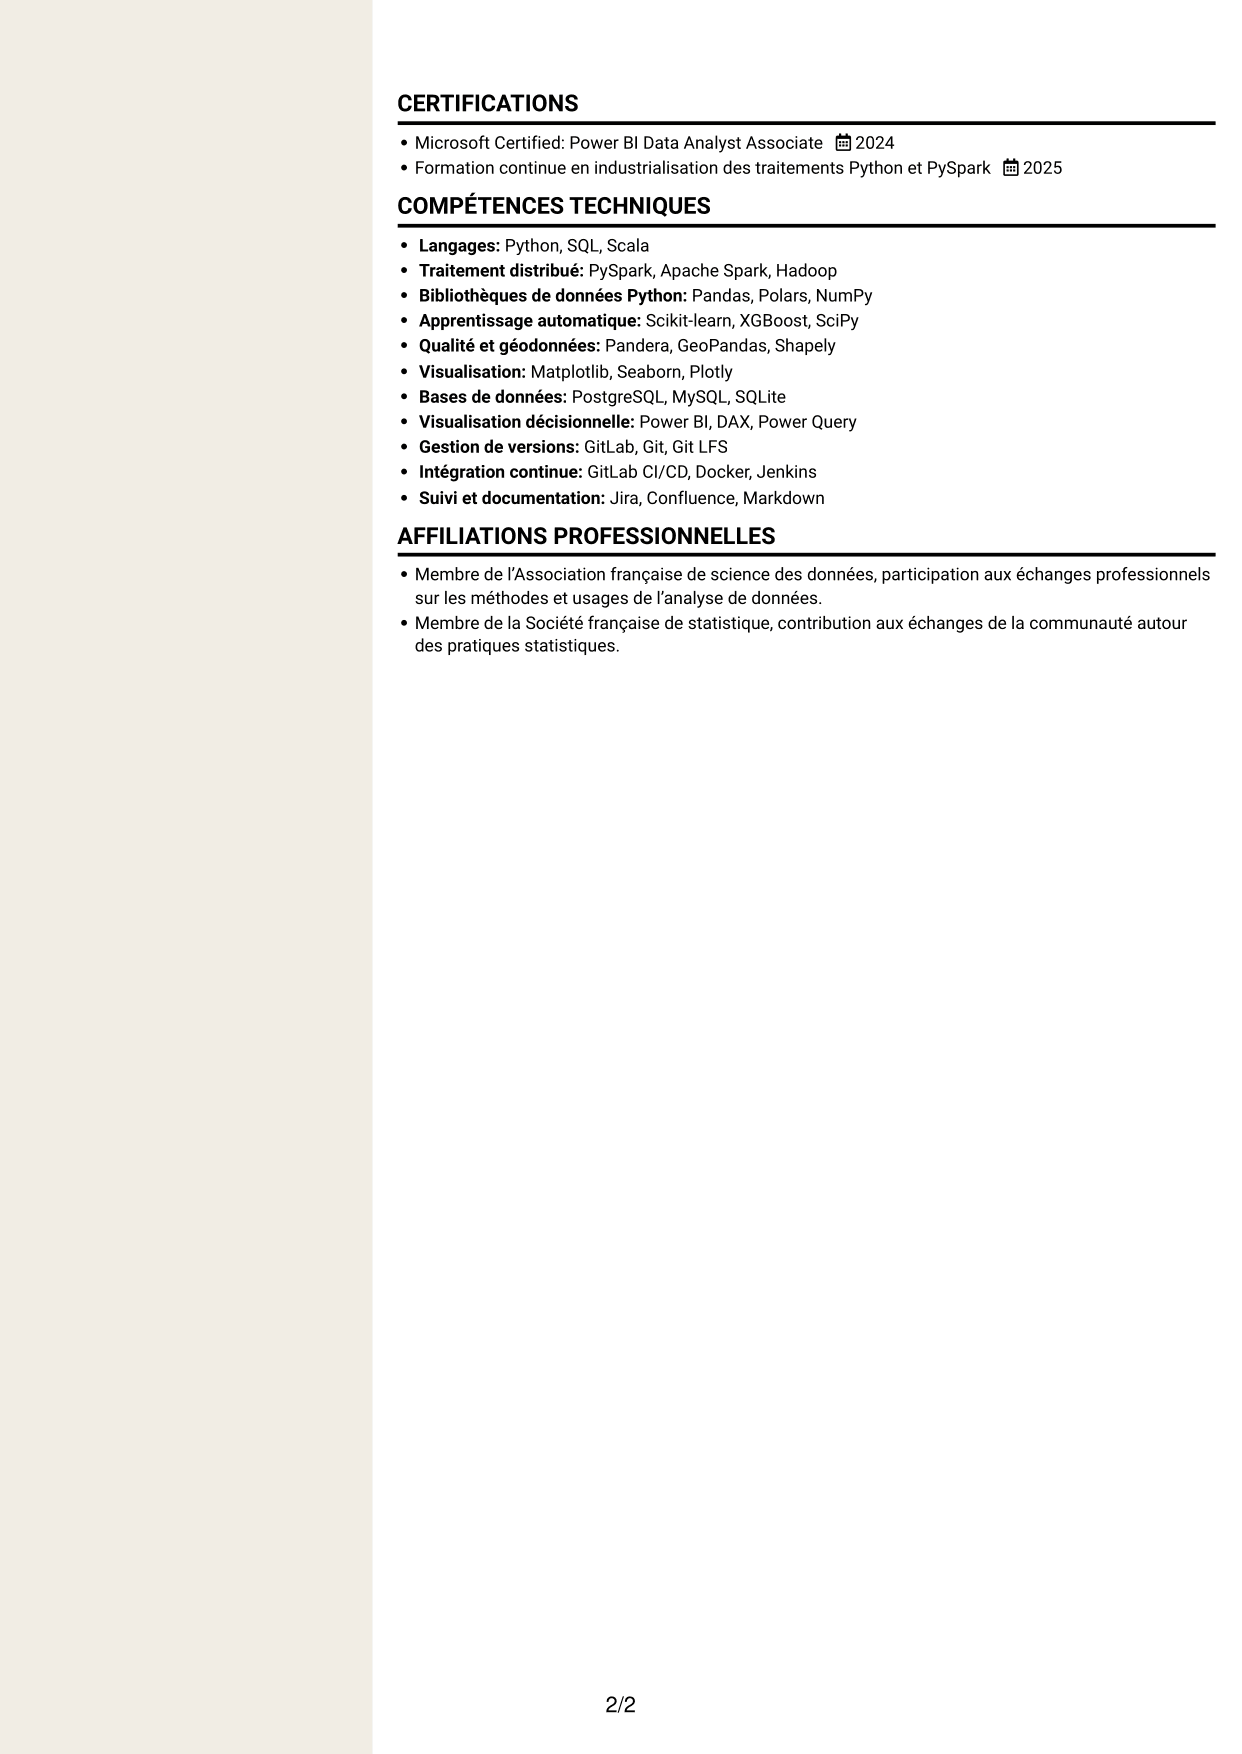
 
CV Fonceur (format à deux colonnes avec en-tête centré sans photo) : Data Scientist - Python et PySpark, page 1   CV Fonceur (format à deux colonnes avec en-tête centré sans photo) : Data Scientist - Python et PySpark, page 2

Pourquoi choisir ce modèle ?

  • L’en-tête centré et encadré rassemble les coordonnées avant le parcours en deux colonnes.
  • La teinte latérale différencie les informations complémentaires du contenu professionnel principal.
  • L’absence de photo laisse l’en-tête et les rubriques porter la présentation visuelle.

À privilégier pour

  • CV sans photo
  • Coordonnées regroupées dans l’en-tête
  • Parcours présenté en deux colonnes
  • Informations complémentaires en zone teintée
  • Repérage distinct de l’en-tête
 

#7 Dynamique (format à deux colonnes avec icônes)

Dynamique associe un en-tête centré, un fond clair et des accents dorés ; ses pictogrammes circulaires sont décoratifs, tandis que les deux colonnes structurent les rubriques.
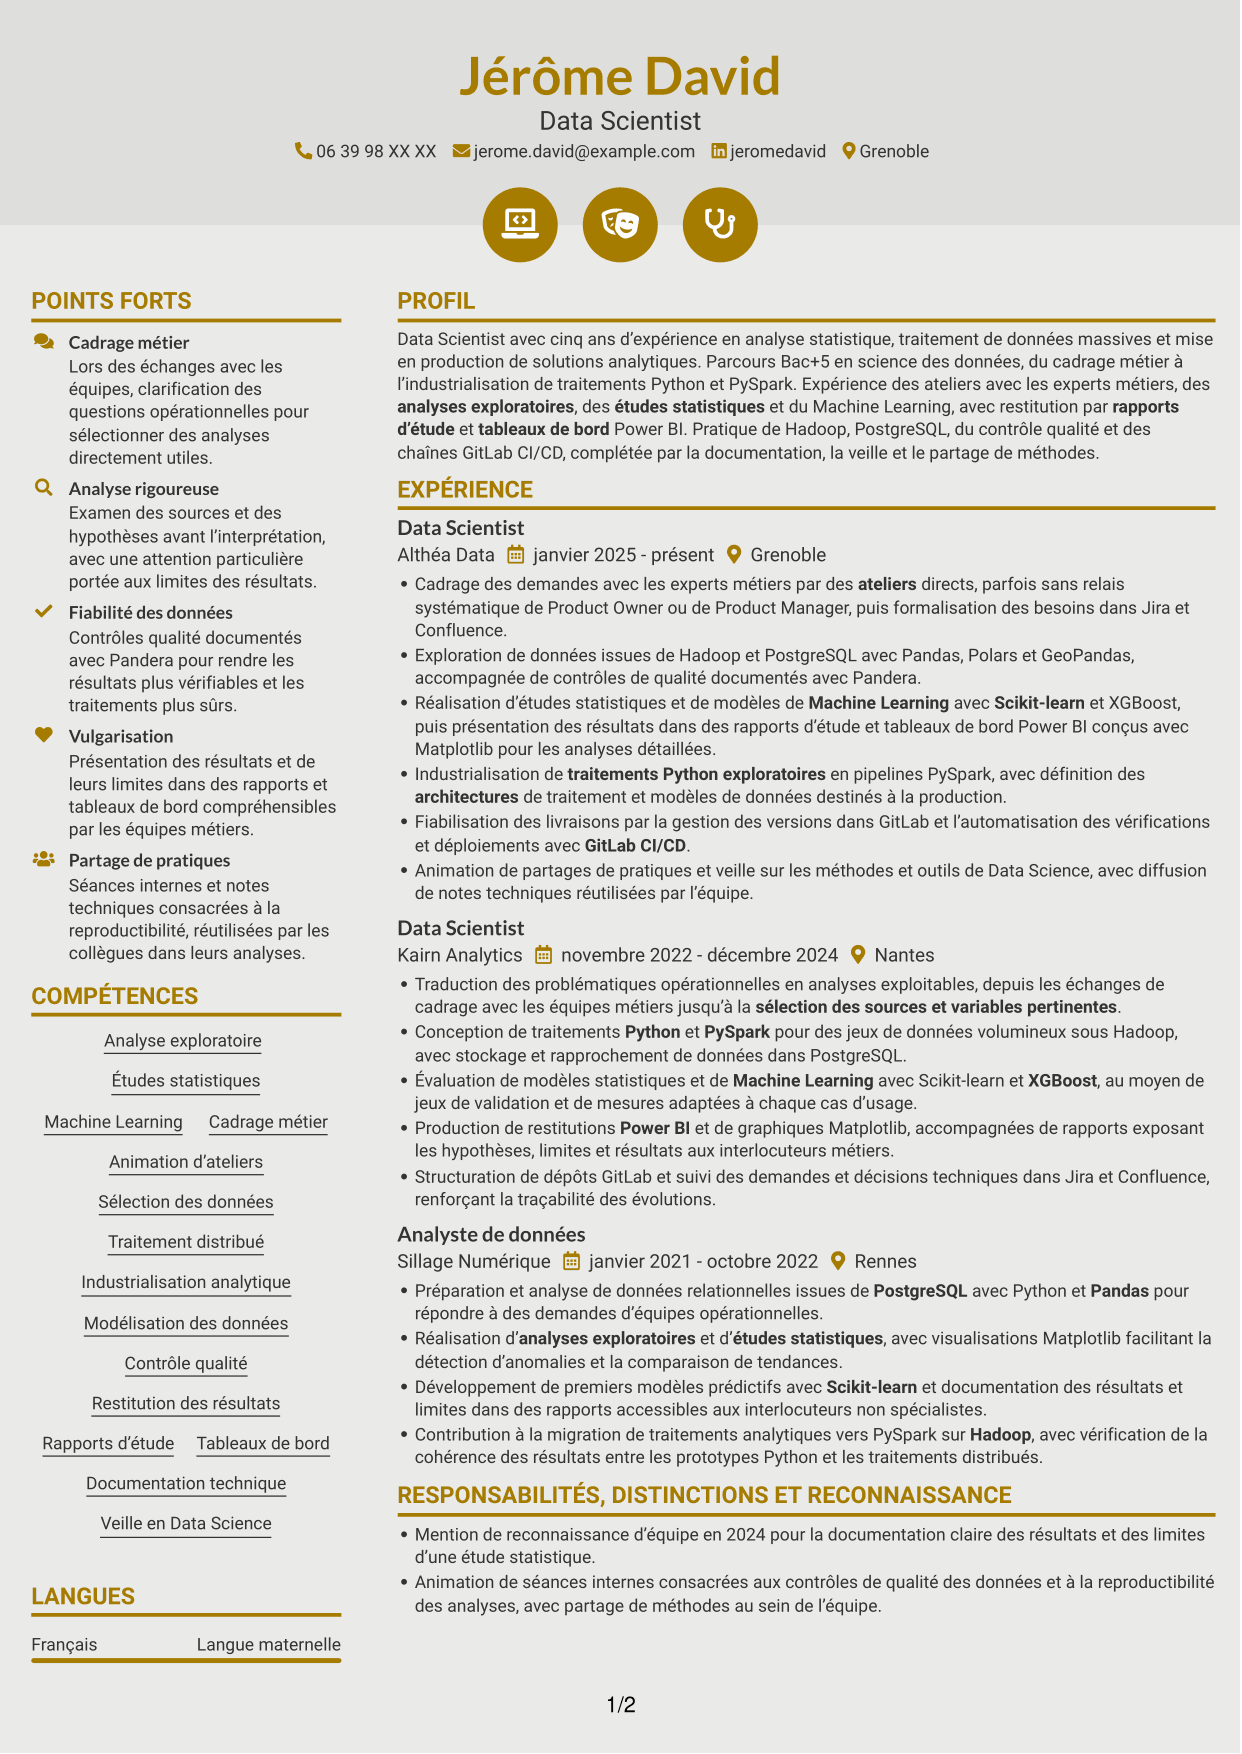
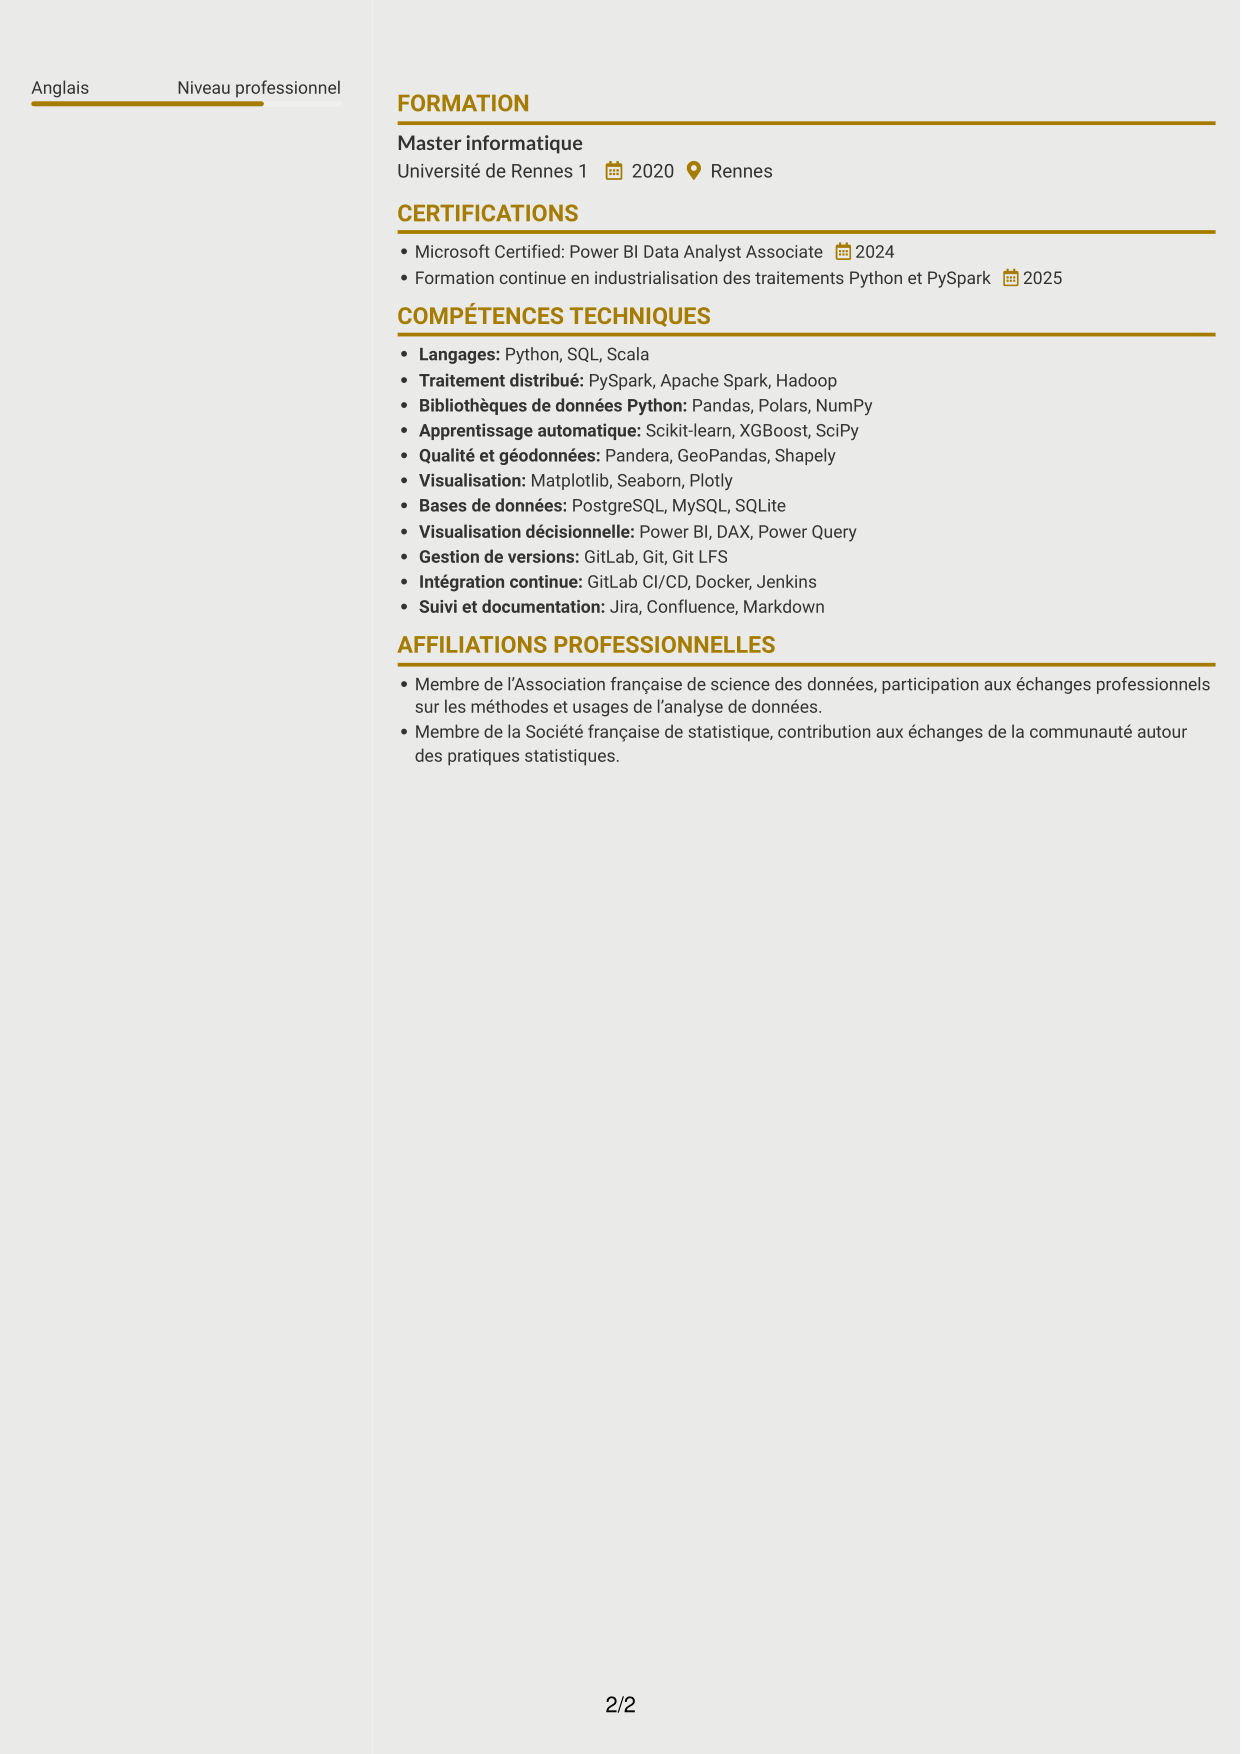
 
CV Dynamique (format à deux colonnes avec icônes) : Data Scientist - Python et PySpark, page 1   CV Dynamique (format à deux colonnes avec icônes) : Data Scientist - Python et PySpark, page 2

Pourquoi choisir ce modèle ?

  • L’en-tête centré donne un point de départ net avant le parcours en deux colonnes.
  • Le fond clair et les accents dorés distinguent les rubriques sans assombrir la page.
  • Les colonnes rendent visibles les liens entre expérience, formation et compétences.

À privilégier pour

  • En-tête centré
  • CV à deux colonnes
  • Rubriques structurées sans photo
  • Accents dorés sur fond clair
  • Présentation avec pictogrammes décoratifs


Pourquoi créer votre CV de Data Scientist avec ResumeInMinutes ?

ResumeInMinutes vous aide à organiser vos compétences, votre formation et vos expériences dans une présentation lisible. Vous pouvez mettre en avant vos traitements Python et PySpark, vos analyses, vos pratiques de contrôle qualité et la restitution de vos résultats.

  • Des mises en page de CV à comparer
  • Des rubriques structurées et lisibles par les ATS
  • Des mots-clés adaptés au poste visé
  • Une organisation claire des compétences et des expériences
  • Des aperçus image des exemples
  • La possibilité de personnaliser un exemple dans l’éditeur

Choisissez une présentation qui rend visibles les étapes clés de votre travail : cadrage métier, sélection des données, analyse, industrialisation et partage des résultats. Appuyez chaque point par des méthodes et des effets que vous pouvez étayer.


Voir aussi


Questions fréquentes

Ces modèles de CV de Data Scientist sont-ils adaptés aux ATS ?

Privilégiez des rubriques explicites, un ordre de lecture logique et des mots-clés intégrés au contexte. Pour ce poste, mentionnez Python, PySpark, Hadoop, PostgreSQL, les analyses statistiques et les outils réellement maîtrisés.

S’agit-il de plusieurs CV différents ?

Non. Il s’agit d’exemples d’un même CV présentés dans différentes mises en page. Les aperçus image permettent de comparer leur organisation avant d’ouvrir un exemple dans l’éditeur.

Que faut-il inclure dans un CV de Data Scientist - Python et PySpark ?

Présentez un résumé professionnel ciblé, vos expériences, votre formation, vos compétences techniques et vos certifications. Décrivez aussi le cadrage des besoins, les analyses, les traitements industrialisés et la restitution, en précisant les outils et résultats étayés par votre parcours.

Comment choisir une mise en page pour un CV de Data Scientist ?

Choisissez une structure qui permet de repérer rapidement les compétences techniques et le parcours professionnel. Vérifiez que les titres de rubriques sont clairs, que la lecture reste fluide et que les informations essentielles ne sont pas reléguées.

Comment décrire ses réalisations en Data Science ?

Utilisez des formulations nominales d’action cohérentes, puis indiquez les méthodes, les outils et les résultats que vous pouvez justifier. Pour un traitement de données, précisez par exemple les étapes de validation, l’industrialisation et l’usage des résultats, sans avancer de mesure non vérifiée.

Faut-il ajouter une photo au CV ?

La photo n’est pas indispensable dans un CV français. Si vous choisissez d’en inclure une, privilégiez une image sobre et veillez à ce qu’elle ne prenne pas la place des compétences et des expériences utiles.

Peut-on personnaliser ces modèles de CV ?

Vous pouvez ouvrir un exemple dans l’éditeur et adapter son contenu et sa présentation au poste de Data Scientist visé. Gardez les compétences et les mots-clés qui correspondent réellement à votre parcours.
Score ATS 100%

Comment ce score est calculé

  • Score ATS = arrondi(0,60 × K + 0,20 × T + 0,20 × Q). K : couverture des mots-clés ; T : composante CV textuel (100 pour le CV évalué ici) ; Q : max(0, 100 − déductions des vérifications du CV).
  • Couverture des mots-clés = arrondi(100 × correspondances confirmées ÷ nombre total de mots-clés). Les correspondances exactes et les équivalences étayées validées par l’IA reçoivent tous les points ; les mots-clés non étayés n’en reçoivent aucun. Les vérifications du texte utilisent les équivalences enregistrées sans nouvelle analyse par l’IA. Sans mots-clés, aucun score ATS global n’est disponible.

Ce que signifie ce score

Nos scores sont des estimations, pas des notes d’employeurs. Ils peuvent contenir des erreurs et ne garantissent ni analyse correcte, ni classement, ni entretien, ni emploi. Vérifiez votre document selon les exigences de l’employeur. Vous êtes responsable de l’utilisation de ce score.

Conditions générales

Pondération : mots-clés 60 % · CV textuel 20 % · Qualité du CV 20 %

Couverture des mots-clés : 32 sur 32 (100 %) · Qualité du CV : 100 %

Qualité du CV 100% · Poids 20% · Problèmes (0)

Détails
  • ✓Nom présent: Jérôme David
  • ✓Format de l’adresse e-mail: jerome.david@example.com
  • ✓Format du numéro de téléphone: 06 39 98 XX XX
  • ✓Expérience 1: Intitulé du poste: Data Scientist
  • ✓Expérience 1: Nom de l’entreprise: Althéa Data
  • ✓Expérience 1: Lieu de travail: Grenoble
  • ✓Expérience 1: Dates d’emploi: janvier 2025 - présent
  • ✓Expérience 1: Description ou réalisations: Présent
  • ✓Expérience 2: Intitulé du poste: Data Scientist
  • ✓Expérience 2: Nom de l’entreprise: Kairn Analytics
  • ✓Expérience 2: Lieu de travail: Nantes
  • ✓Expérience 2: Dates d’emploi: novembre 2022 - décembre 2024
  • ✓Expérience 2: Description ou réalisations: Présent
  • ✓Expérience 3: Intitulé du poste: Analyste de données
  • ✓Expérience 3: Nom de l’entreprise: Sillage Numérique
  • ✓Expérience 3: Lieu de travail: Rennes
  • ✓Expérience 3: Dates d’emploi: janvier 2021 - octobre 2022
  • ✓Expérience 3: Description ou réalisations: Présent
  • ✓Aucun champ provisoire
  • ✓Aucune réalisation répétée
  • ✓Aucune puce vide

Aucun problème détecté lors des vérifications actuelles.

CV textuel 100% · Poids 20%

Texte extrait
Jérôme David
Data Scientist
06 39 98 XX XX
jeromedavid
Grenoble
jerome.david@example.com
POINTS FORTS
Cadrage métier
Lors des échanges avec les équipes, clarification des questions opérationnelles pour sélectionner des analyses directement utiles.
Analyse rigoureuse
Examen des sources et des hypothèses avant l’interprétation, avec une attention particulière portée aux limites des résultats.
Fiabilité des données
Contrôles qualité documentés avec Pandera pour rendre les résultats plus vérifiables et les traitements plus sûrs.
Vulgarisation
Présentation des résultats et de leurs limites dans des rapports et tableaux de bord compréhensibles par les équipes métiers.
Partage de pratiques
Séances internes et notes techniques consacrées à la reproductibilité, réutilisées par les collègues dans leurs analyses.
PROFIL
Data Scientist avec cinq ans d’expérience en analyse statistique, traitement de données massives et mise en production de solutions analytiques. Parcours Bac+5 en science des données, du cadrage métier à l’industrialisation de traitements Python et PySpark. Expérience des ateliers avec les experts métiers, des analyses exploratoires, des études statistiques et du Machine Learning, avec restitution par rapports d’étude et tableaux de bord Power BI. Pratique de Hadoop, PostgreSQL, du contrôle qualité et des chaînes GitLab CI/CD, complétée par la documentation, la veille et le partage de méthodes.
EXPÉRIENCE
Data Scientist
Althéa Data
janvier 2025 - présent
Grenoble
Cadrage des demandes avec les experts métiers par des ateliers directs, parfois sans relais systématique de Product Owner ou de Product Manager, puis formalisation des besoins dans Jira et Confluence.
Exploration de données issues de Hadoop et PostgreSQL avec Pandas, Polars et GeoPandas, accompagnée de contrôles de qualité documentés avec Pandera.
Réalisation d’études statistiques et de modèles de Machine Learning avec Scikit-learn et XGBoost, puis présentation des résultats dans des rapports d’étude et tableaux de bord Power BI conçus avec Matplotlib pour les analyses détaillées.
Industrialisation de traitements Python exploratoires en pipelines PySpark, avec définition des architectures de traitement et modèles de données destinés à la production.
Fiabilisation des livraisons par la gestion des versions dans GitLab et l’automatisation des vérifications et déploiements avec GitLab CI/CD.
Animation de partages de pratiques et veille sur les méthodes et outils de Data Science, avec diffusion de notes techniques réutilisées par l’équipe.
Data Scientist
Kairn Analytics
novembre 2022 - décembre 2024
Nantes
Traduction des problématiques opérationnelles en analyses exploitables, depuis les échanges de cadrage avec les équipes métiers jusqu’à la sélection des sources et variables pertinentes.
Conception de traitements Python et PySpark pour des jeux de données volumineux sous Hadoop, avec stockage et rapprochement de données dans PostgreSQL.
Évaluation de modèles statistiques et de Machine Learning avec Scikit-learn et XGBoost, au moyen de jeux de validation et de mesures adaptées à chaque cas d’usage.
Production de restitutions Power BI et de graphiques Matplotlib, accompagnées de rapports exposant les hypothèses, limites et résultats aux interlocuteurs métiers.
Structuration de dépôts GitLab et suivi des demandes et décisions techniques dans Jira et Confluence, renforçant la traçabilité des évolutions.
Analyste de données
Sillage Numérique
janvier 2021 - octobre 2022
Rennes
Préparation et analyse de données relationnelles issues de PostgreSQL avec Python et Pandas pour répondre à des demandes d’équipes opérationnelles.
Réalisation d’analyses exploratoires et d’études statistiques, avec visualisations Matplotlib facilitant la détection d’anomalies et la comparaison de tendances.
Développement de premiers modèles prédictifs avec Scikit-learn et documentation des résultats et limites dans des rapports accessibles aux interlocuteurs non spécialistes.
Contribution à la migration de traitements analytiques vers PySpark sur Hadoop, avec vérification de la cohérence des résultats entre les prototypes Python et les traitements distribués.
COMPÉTENCES
Rapports d’étude
Machine Learning
Industrialisation analytique
Modélisation des données
Documentation technique
Restitution des résultats
Sélection des données
Veille en Data Science
Analyse exploratoire
Traitement distribué
Animation d’ateliers
Études statistiques
Contrôle qualité
Tableaux de bord
Cadrage métier
RESPONSABILITÉS, DISTINCTIONS ET RECONNAISSANCE
Mention de reconnaissance d’équipe en 2024 pour la documentation claire des résultats et des limites d’une étude statistique.
Animation de séances internes consacrées aux contrôles de qualité des données et à la reproductibilité des analyses, avec partage de méthodes au sein de l’équipe.
LANGUES
Français
Langue maternelle
Anglais
Niveau professionnel
FORMATION
Master informatique
Université de Rennes 1
2020
Rennes
CERTIFICATIONS
Microsoft Certified: Power BI Data Analyst Associate
2024
Formation continue en industrialisation des traitements Python et PySpark
2025
COMPÉTENCES TECHNIQUES
Langages: Python, SQL, Scala
Traitement distribué: PySpark, Apache Spark, Hadoop
Bibliothèques de données Python: Pandas, Polars, NumPy
Apprentissage automatique: Scikit-learn, XGBoost, SciPy
Qualité et géodonnées: Pandera, GeoPandas, Shapely
Visualisation: Matplotlib, Seaborn, Plotly
Bases de données: PostgreSQL, MySQL, SQLite
Visualisation décisionnelle: Power BI, DAX, Power Query
Gestion de versions: GitLab, Git, Git LFS
Intégration continue: GitLab CI/CD, Docker, Jenkins
Suivi et documentation: Jira, Confluence, Markdown
AFFILIATIONS PROFESSIONNELLES
Membre de l’Association française de science des données, participation aux échanges professionnels sur les méthodes et usages de l’analyse de données.
Membre de la Société française de statistique, contribution aux échanges de la communauté autour des pratiques statistiques.

Mots-clés correspondants (32)

  • Master informatiqueMot-clé original dans l’offre: Diplôme de niveau Bac+5
  • cinq ans d’expérience en analyse statistique, traitement de données massives et mise en production de solutions analytiquesMot-clé original dans l’offre: 5 ans d’expérience professionnelle en Data Science
  • Python
  • PySpark
  • analyses exploratoires
  • Études statistiques
  • Machine Learning
  • Cadrage des demandes avec les experts métiers par des ateliers directsMot-clé original dans l’offre: Cadrage des besoins métiers
  • Cadrage des demandes avec les experts métiers par des ateliers directsMot-clé original dans l’offre: Animation d’ateliers métiers
  • sélection des sources et variables pertinentesMot-clé original dans l’offre: Identification des données pertinentes
  • Industrialisation de traitements Python exploratoires en pipelines PySparkMot-clé original dans l’offre: Industrialisation de traitements analytiques
  • définition des architectures de traitement et modèles de données destinés à la productionMot-clé original dans l’offre: Architectures de traitement adaptées à la production
  • Modélisation des données
  • Rapports d’étude
  • tableaux de bord
  • Power BI
  • Hadoop
  • PostgreSQL
  • Scikit-learn
  • XGBoost
  • Pandas
  • Polars
  • Matplotlib
  • Pandera
  • GeoPandas
  • GitLab
  • GitLab CI/CD
  • Jira
  • Confluence
  • Documentation technique
  • Veille en Data Science
  • Partage de pratiques

Mots-clés manquants (0)

Aucun mot-clé manquant.

Avertissement : Tous les noms, images, coordonnées, parcours professionnels, réalisations, habilitations de sécurité, titres militaires et autres qualifications présentés dans ce contenu sont fictifs et utilisés uniquement à des fins d’illustration. Toute ressemblance avec des personnes réelles, vivantes ou décédées, est purement fortuite.

Les exemples de CV et de lettres de motivation et les recommandations de cet article reflètent des bonnes pratiques générales et une expérience professionnelle et sont fournis à titre indicatif uniquement. Les résultats peuvent varier selon le poste, le secteur, la région et l’organisation recruteuse.

Exactitude et vérification du contenu : Dans toute la mesure permise par la loi applicable, nous ne déclarons ni ne garantissons que les conseils, exemples, recommandations ou informations connexes concernant les CV ou lettres de motivation sont exacts, complets, à jour, exempts d’erreurs ou adaptés à un usage particulier. Il vous appartient d’examiner et de vérifier ces informations de manière indépendante avant de vous y fier.

Scores ATS et de lettre de motivation : Les scores ATS sont des estimations calculées selon notre propre formule, fondée sur des conseils accessibles au public concernant la mise en forme des CV et la correspondance des mots-clés. Ils ne sont ni attribués ni approuvés par un fournisseur ATS ou un employeur. Les scores des lettres de motivation sont également nos propres évaluations. L’analyse, la pondération, les critères de sélection et les résultats varient selon les systèmes, les employeurs, les offres et les formats de documents. Aucun score ne garantit une analyse correcte, un classement, un entretien ou un emploi. Utilisez ces scores à titre indicatif et vérifiez vous-même vos documents au regard des exigences de l’employeur. Dans toute la mesure permise par la loi applicable, nous déclinons toute responsabilité pour les erreurs de score ou d’analyse, ou les pertes résultant de la confiance accordée à ces évaluations. Le présent avis n’exclut aucune responsabilité et ne limite aucun droit des consommateurs qui ne peut légalement être exclu ou limité.

Conditions générales
 
> JP 1 1
Configuration des pieds de page et des marges PDF
Les marges sont appliquées au document et le pied de page apparaît à la fois dans l’aperçu et le PDF

Paramètres de la police du pied de page

Postulez-vous à un poste spécifique
afin que nous puissions adapter votre CV en conséquence ?
Postulez-vous à un poste spécifique
afin que nous puissions adapter votre lettre de motivation en conséquence ?

Vos données restent privées et ne sont jamais utilisées à des fins d’entraînement.Politique de confidentialité

Saisissez vos informations sous forme de texte pour générer un CV personnalisé Saisissez vos informations en texte pour générer une lettre de motivation personnalisée
Lien du site trouvé ! Prêt à créer le CV à partir de :

Vos données restent privées et ne sont jamais utilisées à des fins d’entraînement.Politique de confidentialité

Faites glisser le dans la boîte pour vérifier que vous n'êtes pas un robot.
Déposez ici

Mes CV

Affichage de {number_of_files} fichiers (sur un total de {total_of_all_files})
Nom du fichier Type de fichier Dernière modification : Description :

Renommer le fichier

Nom de fichier déjà existant !

Supprimer les fichiers

Avertissement : Cette action est irréversible. Une fois validé, les fichiers seront définitivement supprimés.

Heading text
Téléverser depuis l’ordinateur Téléverser
Sélectionner parmi les existants
LinkedIn
Glissez-déposez des fichiers n’importe où dans cet onglet, ou

Fichiers téléversés

Supprimer Nom du fichier Dernière mise à jour Utiliser ce fichier
Sélectionnez ceci pour utiliser le fichier pour générer votre CV et lettre de motivation. Une seule source — fichier téléversé, fichier sélectionné ou texte LinkedIn — peut être utilisée.

Fichiers

Les CV ou lettres de motivation que vous créez apparaîtront ici. Aucun fichier disponible pour le moment.
Supprimer Nom du fichier Dernière mise à jour Utiliser ce fichier
Sélectionnez ceci pour utiliser le fichier pour générer votre CV et lettre de motivation. Une seule source — fichier téléversé, fichier sélectionné ou texte LinkedIn — peut être utilisée.

Ajouter le PDF de votre profil LinkedIn

Vous pouvez télécharger votre profil LinkedIn au format PDF en ouvrant linkedin.com dans un navigateur, en cliquant sur votre photo de profil, en sélectionnant « Plus » ou « Ressources » puis « Enregistrer au format PDF ». Vous pourrez ensuite joindre le PDF via l’onglet Télécharger depuis l’ordinateur.

Collez le texte de votre profil LinkedIn

Si vous avez copié le texte de votre profil LinkedIn, collez-le ci-dessous. Voir comment copier votre profil sur LinkedIn

Sélectionnez cette option pour utiliser le texte de profil LinkedIn pour générer votre CV et votre lettre de motivation. Une seule source peut être utilisée—fichier téléchargé, sélectionné ou texte LinkedIn.

Essayez ces commandes

<
>